缩放属性 (Scale Properties)
简介
Scale Properties 算法是一种实用算法,用于对节点属性进行预处理以供模型训练,或对算法结果(如 PageRank 分数)进行后处理。它根据指定的缩放器对节点属性进行缩放。可以一次性缩放多个属性,结果以列表属性的形式返回。
输入属性必须是数字或数字列表。所有列表的大小必须相同。输出属性始终为列表。输出列表的长度等于所有输入属性长度之和。也就是说,如果输入属性包括两个标量数值属性和一个长度为三的列表属性,则输出列表的总长度为五。
如果节点缺少某属性的值,则该节点在该属性的缩放中会被省略,输出值为 NaN。这同样适用于列表属性。
Scale Properties 算法支持多种缩放器。可以通过 scaler 配置参数进行设置。
列表属性按索引逐个进行缩放。更多细节请参见 列表示例。
在下列公式中,p 表示包含图中所有节点对于单一属性的所有属性值的向量。
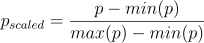
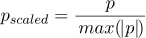
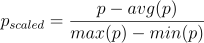
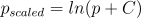
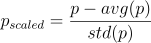
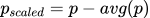
语法
本节介绍在各种执行模式下运行 Scale Properties 算法的语法。这里描述的是命名图(named graph)变体的语法。如需了解其他通用语法变体,请参见 语法概览。
CALL gds.scaleProperties.stream(
  graphName: String,
  configuration: Map
) YIELD
  nodeId: Integer,
scaledProperty: List of Float| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。具有任何给定标签的节点都将被包含。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。具有任何给定类型的关系都将被包含。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
nodeProperties |
字符串列表 |
|
否 |
要缩放的节点属性名称。所有属性名称必须存在于投影图中。 |
scaler |
字符串或映射 |
|
否 |
用于属性的缩放器名称。支持的取值(不区分大小写)有 |
| 名称 | 类型 | 描述 |
|---|---|---|
nodeId |
整数 |
节点 ID。 |
scaledProperty |
浮点数列表 |
每个输入节点属性的缩放后值。 |
CALL gds.scaleProperties.mutate(
  graphName: String,
  configuration: Map
) YIELD
  scalerStatistics: Map,
  preProcessingMillis: Integer,
  computeMillis: Integer,
  mutateMillis: Integer,
  postProcessingMillis: Integer,
  nodePropertiesWritten: Integer,
configuration: Map| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
mutateProperty |
字符串 |
|
否 |
写入缩放属性的 GDS 图中的节点属性。 |
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
nodeProperties |
字符串列表 |
|
否 |
要缩放的节点属性名称。所有属性名称必须存在于投影图中。 |
scaler |
字符串或映射 |
|
否 |
用于属性的缩放器名称。支持的取值(不区分大小写)有 |
| 名称 | 类型 | 描述 |
|---|---|---|
scalerStatistics |
Map |
指定缩放器计算的统计信息(如果有)。 |
preProcessingMillis |
整数 |
预处理数据的毫秒数。 |
computeMillis |
整数 |
运行算法的毫秒数。 |
mutateMillis |
整数 |
向投影图添加属性的毫秒数。 |
postProcessingMillis |
整数 |
未使用。 |
nodePropertiesWritten |
整数 |
已写入的节点属性数量。 |
配置 |
Map |
运行算法所使用的配置。 |
CALL gds.scaleProperties.stats(
  graphName: String,
  configuration: Map
)
YIELD
  scalerStatistics: Map,
  preProcessingMillis: Integer,
  computeMillis: Integer,
  postProcessingMillis: Integer,
configuration: Map| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。具有任何给定标签的节点都将被包含。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。具有任何给定类型的关系都将被包含。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
nodeProperties |
字符串列表 |
|
否 |
要缩放的节点属性名称。所有属性名称必须存在于投影图中。 |
scaler |
字符串或映射 |
|
否 |
用于属性的缩放器名称。支持的取值(不区分大小写)有 |
| 名称 | 类型 | 描述 |
|---|---|---|
scalerStatistics |
Map |
指定缩放器计算的统计信息(如果有)。 |
preProcessingMillis |
整数 |
预处理数据的毫秒数。 |
computeMillis |
整数 |
运行算法的毫秒数。 |
postProcessingMillis |
整数 |
未使用。 |
配置 |
Map |
运行算法所使用的配置。 |
CALL gds.scaleProperties.write(
  graphName: String,
  configuration: Map
)
YIELD
  scalerStatistics: Map,
  preProcessingMillis: Integer,
  computeMillis: Integer,
  writeMillis: Integer,
  postProcessingMillis: Integer,
  nodePropertiesWritten: Integer,
configuration: Map| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。具有任何给定标签的节点都将被包含。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。具有任何给定类型的关系都将被包含。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
整数 |
|
是 |
用于将结果写入 Neo4j 的并发线程数。 |
|
字符串 |
|
否 |
写入 Neo4j 数据库中缩放属性的节点属性。 |
|
nodeProperties |
字符串列表 |
|
否 |
要缩放的节点属性名称。所有属性名称必须存在于投影图中。 |
scaler |
字符串或映射 |
|
否 |
用于属性的缩放器名称。支持的取值(不区分大小写)有 |
| 名称 | 类型 | 描述 |
|---|---|---|
scalerStatistics |
Map |
指定缩放器计算的统计信息(如果有)。 |
preProcessingMillis |
整数 |
预处理数据的毫秒数。 |
computeMillis |
整数 |
运行算法的毫秒数。 |
writeMillis |
整数 |
将结果写回 Neo4j 所用的毫秒数。 |
postProcessingMillis |
整数 |
未使用。 |
nodePropertiesWritten |
整数 |
已写入的节点属性数量。 |
配置 |
Map |
运行算法所使用的配置。 |
示例
|
以下所有示例应在空数据库中运行。 这些示例均使用 Cypher 投影 作为标准。原生投影将在未来版本中被弃用。 |
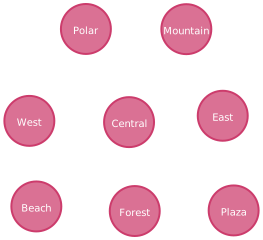
本节将展示在具体图上运行 Scale Properties 算法的示例。目的是说明结果的样子,并提供在真实场景中使用该算法的指南。我们将在一个包含少量节点并以特定模式相连的酒店示例图上进行演示。示例图如下所示
CREATE
  (:Hotel {avgReview: 4.2, buildYear: 1978, storyCapacity: [32, 32, 0], name: 'East'}),
  (:Hotel {avgReview: 8.1, buildYear: 1958, storyCapacity: [18, 20, 0], name: 'Plaza'}),
  (:Hotel {avgReview: 19.0, buildYear: 1999, storyCapacity: [100, 100, 70], name: 'Central'}),
  (:Hotel {avgReview: -4.12, buildYear: 2005, storyCapacity: [250, 250, 250], name: 'West'}),
  (:Hotel {avgReview: 0.01, buildYear: 2020, storyCapacity: [1250, 1250, 900], name: 'Polar'}),
  (:Hotel {avgReview: 3.3, buildYear: 1981, storyCapacity: [240, 240, 0], name: 'Beach'}),
  (:Hotel {avgReview: 6.7, buildYear: 1984, storyCapacity: [80, 0, 0], name: 'Mountain'}),
  (:Hotel {avgReview: -1.2, buildYear: 2010, storyCapacity: [55, 20, 0], name: 'Forest'})
在 Neo4j 中创建好图后,我们可以将其投影到图目录中,为算法执行做准备。我们使用针对 Hotel 节点的 Cypher 投影,并包括它们的属性。请注意,缩放节点属性不需要任何关系。
MATCH (hotel:Hotel)
RETURN gds.graph.project(
  'myGraph',
  hotel,
  null,
  {
    sourceNodeProperties: hotel { .avgReview, .buildYear, .storyCapacity },
    targetNodeProperties: {}
  }
)
以下示例演示如何缩放此图的节点属性。
内存估算
首先,我们将使用 estimate 过程来估算运行算法的成本。这可以在任何执行模式下完成。在本示例中,我们将使用 stream 模式。估算算法有助于了解在您的图上运行该算法会产生什么样的内存影响。当您稍后在某个执行模式下实际运行算法时,系统会执行一次估算。如果估算结果显示执行超出内存限制的可能性极高,则禁止执行。要了解更多信息,请参阅 自动估算和执行阻塞。
有关 estimate 的更多详细信息,请参阅 内存估算。
CALL gds.scaleProperties.stream.estimate('myGraph', {
  nodeProperties: ['buildYear', 'storyCapacity'],
  scaler: 'MinMax'
})
YIELD nodeCount, relationshipCount, bytesMin, bytesMax, requiredMemory| nodeCount | relationshipCount | bytesMin | bytesMax | requiredMemory |
|---|---|---|---|---|
8 |
0 |
480 |
480 |
"480 Bytes" |
流模式
在 `stream`(流)执行模式下,算法返回每个节点的缩放属性。这使我们能够直接检查结果或在 Cypher 中进行后处理而不会产生副作用。请注意,输出始终是一个单一的列表属性,包含输入顺序中的所有缩放节点属性。
有关 stream 模式的更多详细信息,请参阅 流模式。
stream 模式运行该算法:CALL gds.scaleProperties.stream('myGraph', {
nodeProperties: ['buildYear', 'avgReview'],
scaler: 'MinMax'
}) YIELD nodeId, scaledProperty
RETURN gds.util.asNode(nodeId).name AS name, scaledProperty
ORDER BY name ASC| 名称 (name) | scaledProperty |
|---|---|
"Beach" |
[0.3709677419354839, 0.3209342560553633] |
"Central" |
[0.6612903225806451, 1.0] |
"East" |
[0.3225806451612903, 0.35986159169550175] |
"Forest" |
[0.8387096774193549, 0.12629757785467127] |
"Mountain" |
[0.41935483870967744, 0.4679930795847751] |
"Plaza" |
[0.0, 0.5285467128027681] |
"Polar" |
[1.0, 0.17863321799307957] |
"West" |
[0.7580645161290323, 0.0] |
从结果中可以看到,`scaledProperty` 的第一个元素是 `buildYear` 的最小-最大缩放值,其中 `Plaza` 酒店的值最小,缩放后为 0,而 `Polar` 酒店的值最大,缩放后为 1。可以用示例图验证。`scaledProperty` 的第二个值是 `avgReview` 属性的缩放值。
Mutate
`mutate`(变异)执行模式可在命名图中添加一个新节点属性,以存储该节点的缩放属性。新属性的名称需通过必填配置参数 `mutateProperty` 指定。结果为单行摘要,包含计算指标。当多个算法联用时,`mutate` 模式尤为有用。
有关 mutate 模式的更多详细信息,请参阅 修改模式。
本例中,我们将使用 均值缩放器 对 `buildYear` 和 `avgReview` 两个酒店属性进行缩放。输出为一个列表属性,命名为 `hotelFeatures`,设想后续将其作为机器学习模型的输入。
mutate 模式运行该算法:CALL gds.scaleProperties.mutate('myGraph', {
nodeProperties: ['buildYear', 'avgReview'],
scaler: 'Mean',
mutateProperty: 'hotelFeatures'
}) YIELD nodePropertiesWritten, scalerStatistics| nodePropertiesWritten | scalerStatistics |
|---|---|
8 |
{avgReview={avg=[4.49875], max=[19.0], min=[-4.12]}, buildYear={avg=[1991.875], max=[2020.0], min=[1958.0]}} |
结果显示,内存图中现在有八个新节点属性。这些属性包含输入属性的缩放值,其中缩放后的 `buildYear` 值位于列表的第一个位置,`avgReview` 的缩放值位于第二个位置。欲了解如何检查内存图的新模式,请参见 图目录中的图列表。
统计信息 (Stats)
在 `stats`(统计)执行模式下,算法返回一行,包含算法结果的摘要。此模式没有任何副作用。通过检查 `computeMillis` 返回项,可用于评估算法性能。下面的示例中将省略返回时间信息。过程的完整签名见 语法章节。
欲了解 `stats` 模式的更多细节,请参见 统计模式。
CALL gds.scaleProperties.stats('myGraph', {
  nodeProperties: ['buildYear', 'avgReview'],
  scaler: 'center'
}) YIELD scalerStatistics| scalerStatistics |
|---|
{avgReview={avg=[4.49875]}, buildYear={avg=[1991.875]}} |
不同的缩放器在计算过程中需要生成不同的统计量,这将在返回的 `scalerStatistics` 中体现。由于 “Center” 计算各输入属性的平均值,所以这里的缩放统计结果即为平均值。
Write
`write`(写入)执行模式在 `stats` 模式的基础上增加了一个重要的副作用:将每个节点的缩放属性写入 Neo4j 数据库的属性中。新属性的名称通过必填配置参数 `writeProperty` 指定。结果为单行摘要,与 `stats` 类似,但包含一些额外指标。`write` 模式可直接将结果持久化到数据库。
有关 write 模式的更多详细信息,请参阅 写入模式。
write 模式运行该算法:CALL gds.scaleProperties.write('myGraph', {
nodeProperties: ['buildYear', 'avgReview'],
scaler: 'stdscore',
writeProperty: 'hotelStdScore'
}) YIELD nodePropertiesWritten, scalerStatistics| nodePropertiesWritten | scalerStatistics |
|---|---|
8 |
{avgReview={avg=[4.49875], std=[6.6758378454]}, buildYear={avg=[1991.875], std=[18.9171714323]}} |
结果显示,数据库图中对应投影 `'myGraph'` 的节点上现在有八个新节点属性。这些属性包含输入属性的缩放值,其中缩放后的 `buildYear` 值位于列表的第一个位置,`avgReview` 的缩放值位于第二个位置。
列表属性
`storyCapacity` 属性表示酒店每层的房间数量。该属性经过归一化,使得楼层较少的酒店其值为零。这是因为 Scale Properties 算法要求同一属性的所有值具有相同长度。本文示例演示如何使用 Scale Properties 算法对这些列表中的值进行缩放。我们设想将输出作为机器学习算法的特征向量;此外,还会在特征向量中加入 `avgReview` 属性。
CALL gds.scaleProperties.stream('myGraph', {
  nodeProperties: ['avgReview', 'storyCapacity'],
  scaler: 'StdScore'
}) YIELD nodeId, scaledProperty
RETURN gds.util.asNode(nodeId).name AS name, scaledProperty AS features
ORDER BY name ASC| 名称 (name) | features |
|---|---|
"Beach" |
[-0.17956547594003253, -0.03401933556831381, 0.00254261210704973, -0.5187592498702616] |
"Central" |
[2.172199255871029, -0.3968922482969945, -0.3534230828799124, -0.2806402499298136] |
"East" |
[-0.0447509371737933, -0.5731448059080679, -0.526320706159294, -0.5187592498702616] |
"Forest" |
[-0.8536381697712284, -0.513529970245499, -0.5568320514438908, -0.5187592498702616] |
"Mountain" |
[0.32973389273242665, -0.4487312358296632, -0.6076842935848854, -0.5187592498702616] |
"Plaza" |
[0.5394453974799097, -0.609432097180936, -0.5568320514438908, -0.5187592498702616] |
"Polar" |
[-0.672387512096618, 2.583849534831454, 2.5705808402272767, 2.542770749364069] |
"West" |
[-1.2910364511016934, -0.00809984180197948, 0.027968733177547028, 0.3316657499170525] |
生成的特征向量在列表的第一个位置包含 `avgReview` 属性的标准分数缩放值。我们可以看到有些值为负数,且 `Central` 酒店的最大值十分突出。
其余三个列表位置是 `storyCapacity` 列表属性的缩放值。请注意,每个列表项仅相对于其他列表中对应位置的项进行缩放。因此,`Polar` 酒店在所有列表位置上都有最高的缩放值。
使用带偏移的对数缩放
`log` 缩放器支持可配置的偏移参数。下面的示例演示如何设置该偏移。
我们想要缩放 `avgReview` 属性,但其中包含负数,负数的对数未定义。首先,使用 Cypher 的聚合函数 `min()` 来确定最小值。
CALL gds.graph.nodeProperty.stream('myGraph', 'avgReview') YIELD propertyValue
RETURN min(propertyValue) AS minimumAvgReview
| minimumAvgReview |
|---|
-4.12 |
得到该值后,我们可以使用更大的值,从而保证对数为有限值。这里使用 `5.12`,使得最小的缩放值为零。
CALL gds.scaleProperties.stream('myGraph', {
  nodeProperties: ['avgReview'],
  scaler: {type: 'Log', offset: 5.12}
}) YIELD nodeId, scaledProperty
RETURN gds.util.asNode(nodeId).name AS name, scaledProperty
ORDER BY name ASC| 名称 (name) | scaledProperty |
|---|---|
"Beach" |
[2.130609828254235] |
"Central" |
[3.183041371858985] |
"East" |
[2.2321626286975] |
"Forest" |
[1.366091653802371] |
"Mountain" |
[2.469793011977952] |
"Plaza" |
[2.581730834423540] |
"Polar" |
[1.635105659182678] |
"West" |
[0.0] |
如我们所见,所有缩放值都是有限数,尤其是最小的缩放值为零。如果好奇结果,可尝试使用低于 `4.12` 的偏移值。