A* 最短路径
术语表
- 有向
-
有向特征。该算法在有向图上定义良好。
- 有向
-
有向特征。该算法忽略图的方向。
- 有向
-
有向特征。该算法不能在有向图上运行。
- 无向
-
无向特征。该算法在无向图上定义良好。
- 无向
-
无向特征。该算法忽略图的无向性。
- 异构节点
-
异构节点完全支持。该算法有能力区分不同类型的节点。
- 异构节点
-
异构节点允许。该算法平等对待所有选定的节点,无论其标签如何。
- 异构关系
-
异构关系完全支持。该算法有能力区分不同类型的关系。
- 异构关系
-
异构关系允许。该算法平等对待所有选定的关系,无论其类型如何。
- 加权关系
-
加权特征。该算法支持将关系属性用作权重,通过 relationshipWeightProperty 配置参数指定。
- 加权关系
-
加权特征。该算法将每个关系视为同等重要,忽略任何关系权重值。
- 节点属性
-
节点属性特征。该算法使用节点属性。
简介
A*(发音为“A-Star”)最短路径算法用于计算两个节点之间的最短路径。A* 是一种启发式搜索算法,它使用启发式函数来指导图遍历。该算法支持具有正向关系权重的加权图。
与 Dijkstra 最短路径算法不同,A* 下一个要搜索的节点不仅仅基于已计算的距离。相反,该算法将已计算的距离与启发式函数的结果相结合。该函数以节点作为输入,并返回一个对应于从该节点到达目标节点代价的值。在每次迭代中,图遍历将从具有最低组合代价的节点继续。
在 GDS 中,A* 算法基于 Dijkstra 最短路径算法。其启发式函数是半正矢(haversine)距离,它定义了球面上两点之间的距离。在这里,球面是地球,点是存储在图节点上的地理坐标。
该算法的实现是使用单线程执行的。更改并发配置不会产生任何影响。
要求
在 GDS 中,用于指导搜索的启发式函数是 半正矢公式。该公式根据给定的经度和纬度计算球面上两点之间的距离。距离的计算单位是海里。
为了保证找到最优解(即两点之间的最短路径),启发式函数必须是可采纳的(admissible)。要满足可采纳性,函数不得高估到目标的距离,即路径的最低可能代价必须始终大于或等于启发式函数的值。
这导致了对输入图关系权重的要求。关系权重必须表示两个节点之间的距离,并且理想情况下缩放为海里。千米或英里也可以,但该启发式函数在海里下效果最佳。
语法
本节涵盖了在每种执行模式下执行 A* 算法所使用的语法。我们描述的是命名图变体的语法。要了解有关通用语法变体的更多信息,请参阅 语法概述。
CALL gds.shortestPath.astar.stream(
  graphName: String,
  configuration: Map
)
YIELD
  index: Integer,
  sourceNode: Integer,
  targetNode: Integer,
  totalCost: Float,
  nodeIds: List of Integer,
  costs: List of Float,
path: Path| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。具有任何给定标签的节点都将被包含。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。具有任何给定类型的关系都将被包含。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
sourceNode |
整数 |
|
否 |
Neo4j 源节点或节点 ID。 |
targetNode |
整数 |
|
否 |
Neo4j 目标节点或节点 ID。 |
latitudeProperty |
浮点数 |
|
否 |
存储纬度值的节点属性。 |
longitudeProperty |
浮点数 |
|
否 |
存储经度值的节点属性。 |
字符串 |
|
是 |
用作权重的关系属性名称。如果未指定,算法将作为无权重运行。 |
|
| 名称 | 类型 | 描述 |
|---|---|---|
index |
整数 |
已发现路径的从 0 开始的索引。 |
sourceNode |
整数 |
路径的源节点。 |
targetNode |
整数 |
路径的目标节点。 |
totalCost |
浮点数 |
从源到目标的总成本。 |
nodeIds |
整数列表 |
遍历顺序中路径上的节点 ID。 |
costs |
浮点数列表 |
路径上每个节点的累计成本。 |
path |
路径 |
以 Cypher 实体表示的路径。 |
变异(mutate)模式在投影图中创建新的关系。每种关系代表从源节点到目标节点的一条路径。路径的总成本存储在 totalCost 关系属性中。
CALL gds.shortestPath.astar.mutate(
  graphName: String,
  configuration: Map
)
YIELD
  relationshipsWritten: Integer,
  preProcessingMillis: Integer,
  computeMillis: Integer,
  postProcessingMillis: Integer,
  mutateMillis: Integer,
configuration: Map| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
mutateRelationshipType |
字符串 |
|
否 |
用于写入投影图的新关系的关系类型。 |
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
sourceNode |
整数 |
|
否 |
Neo4j 源节点或节点 ID。 |
targetNode |
整数 |
|
否 |
Neo4j 目标节点或节点 ID。 |
latitudeProperty |
浮点数 |
|
否 |
存储纬度值的节点属性。 |
longitudeProperty |
浮点数 |
|
否 |
存储经度值的节点属性。 |
字符串 |
|
是 |
用作权重的关系属性名称。如果未指定,算法将作为无权重运行。 |
| 名称 | 类型 | 描述 |
|---|---|---|
preProcessingMillis |
整数 |
预处理图的毫秒数。 |
computeMillis |
整数 |
运行算法的毫秒数。 |
postProcessingMillis |
整数 |
未使用。 |
mutateMillis |
整数 |
向投影图添加关系所需的毫秒数。 |
relationshipsWritten |
整数 |
添加的关系数量。 |
配置 |
Map |
用于运行算法的配置。 |
写入(write)模式在 Neo4j 数据库中创建新的关系。每种关系代表从源节点到目标节点的一条路径。额外的路径信息使用关系属性存储。默认情况下,写入模式存储 totalCost 属性。用户还可以选择存储路径上中间节点的 nodeIds 和 costs。
CALL gds.shortestPath.astar.write(
  graphName: String,
  configuration: Map
)
YIELD
  relationshipsWritten: Integer,
  preProcessingMillis: Integer,
  computeMillis: Integer,
  postProcessingMillis: Integer,
  writeMillis: Integer,
configuration: Map| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphName |
字符串 |
|
否 |
存储在目录中的图的名称。 |
配置 |
Map |
|
是 |
算法特定配置和/或图过滤配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
字符串列表 |
|
是 |
使用给定的节点标签过滤命名图。具有任何给定标签的节点都将被包含。 |
|
字符串列表 |
|
是 |
使用给定的关系类型过滤命名图。具有任何给定类型的关系都将被包含。 |
|
整数 |
|
是 |
用于运行算法的并发线程数。 |
|
字符串 |
|
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
布尔值 |
|
是 |
如果禁用,进度百分比将不会被记录。 |
|
整数 |
|
是 |
用于将结果写入 Neo4j 的并发线程数。 |
|
writeRelationshipType |
字符串 |
|
否 |
用于将计算出的关系持久化到 Neo4j 数据库的关系类型。 |
sourceNode |
整数 |
|
否 |
Neo4j 源节点或节点 ID。 |
targetNode |
整数 |
|
否 |
Neo4j 目标节点或节点 ID。 |
latitudeProperty |
浮点数 |
|
否 |
存储纬度值的节点属性。 |
longitudeProperty |
浮点数 |
|
否 |
存储经度值的节点属性。 |
字符串 |
|
是 |
用作权重的关系属性名称。如果未指定,算法将作为无权重运行。 |
|
writeNodeIds |
布尔值 |
|
是 |
如果为 true,则写入的关系具有 nodeIds 列表属性。 |
writeCosts |
布尔值 |
|
是 |
如果为 true,则写入的关系具有 costs 列表属性。 |
| 名称 | 类型 | 描述 |
|---|---|---|
preProcessingMillis |
整数 |
预处理图的毫秒数。 |
computeMillis |
整数 |
运行算法的毫秒数。 |
postProcessingMillis |
整数 |
未使用。 |
writeMillis |
整数 |
将关系写入 Neo4j 所需的毫秒数。 |
relationshipsWritten |
整数 |
写入的关系数量。 |
配置 |
Map |
用于运行算法的配置。 |
示例
|
以下所有示例应在空数据库中运行。 这些示例将 Cypher 投影作为规范。原生投影将在未来版本中弃用。 |
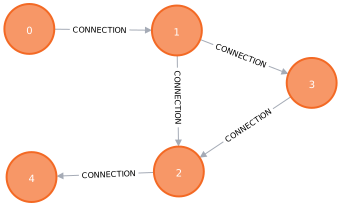
在本节中,我们将展示在具体图上运行 A* 算法的示例。目的是说明结果的样子,并为如何在实际环境中使用该算法提供指导。我们将在一个小型交通网络图上进行演示,图中包含以特定模式连接的少数几个节点。示例图如下所示:
CREATE (a:Station {name: 'Kings Cross',         latitude: 51.5308, longitude: -0.1238}),
       (b:Station {name: 'Euston',              latitude: 51.5282, longitude: -0.1337}),
       (c:Station {name: 'Camden Town',         latitude: 51.5392, longitude: -0.1426}),
       (d:Station {name: 'Mornington Crescent', latitude: 51.5342, longitude: -0.1387}),
       (e:Station {name: 'Kentish Town',        latitude: 51.5507, longitude: -0.1402}),
       (a)-[:CONNECTION {distance: 0.7}]->(b),
       (b)-[:CONNECTION {distance: 1.3}]->(c),
       (b)-[:CONNECTION {distance: 0.7}]->(d),
       (d)-[:CONNECTION {distance: 0.6}]->(c),
       (c)-[:CONNECTION {distance: 1.3}]->(e)
该图表示一个车站交通网络。每个车站都有一个地理坐标,由 latitude(纬度)和 longitude(经度)属性表示。车站之间通过连接相连。我们使用 distance 属性作为关系权重,它表示车站之间的千米距离。算法将根据已走过的距离和到目标车站的距离来选择搜索中的下一个节点。
MATCH (source:Station)-[r:CONNECTION]->(target:Station)
RETURN gds.graph.project(
  'myGraph',
  source,
  target,
  {
    sourceNodeProperties: source { .latitude, .longitude },
    targetNodeProperties: target { .latitude, .longitude },
    relationshipProperties: r { .distance }
  }
)
在以下示例中,我们将演示如何使用此图来运行 A* 最短路径算法。
内存估算
首先,我们将使用 estimate 过程估算运行算法的成本。这可以在任何执行模式下完成。在这个例子中我们将使用 write 模式。估算算法有助于了解在您的图上运行该算法将产生的内存影响。当您随后在其中一种执行模式下真正运行算法时,系统将执行一次估算。如果估算显示执行超出其内存限制的可能性非常高,则禁止执行。要阅读更多关于此的内容,请参阅 自动估算和执行阻塞。
有关 estimate 的更多详细信息,请参阅 内存估算。
MATCH (source:Station {name: 'Kings Cross'}), (target:Station {name: 'Kentish Town'})
CALL gds.shortestPath.astar.write.estimate('myGraph', {
    sourceNode: source,
    targetNode: target,
    latitudeProperty: 'latitude',
    longitudeProperty: 'longitude',
    writeRelationshipType: 'PATH'
})
YIELD nodeCount, relationshipCount, bytesMin, bytesMax, requiredMemory
RETURN nodeCount, relationshipCount, bytesMin, bytesMax, requiredMemory| nodeCount | relationshipCount | bytesMin | bytesMax | requiredMemory |
|---|---|---|---|---|
5 |
5 |
1016 |
1016 |
"1016 字节" |
流(Stream)
在 stream 执行模式下,算法返回每一对源-目标的最短路径。这使我们能够直接检查结果或在 Cypher 中对其进行后处理,而不会产生任何副作用。
有关 stream 模式的更多详细信息,请参阅 流式读取。
MATCH (source:Station {name: 'Kings Cross'}), (target:Station {name: 'Kentish Town'})
CALL gds.shortestPath.astar.stream('myGraph', {
    sourceNode: source,
    targetNode: target,
    latitudeProperty: 'latitude',
    longitudeProperty: 'longitude',
    relationshipWeightProperty: 'distance'
})
YIELD index, sourceNode, targetNode, totalCost, nodeIds, costs, path
RETURN
    index,
    gds.util.asNode(sourceNode).name AS sourceNodeName,
    gds.util.asNode(targetNode).name AS targetNodeName,
    totalCost,
    [nodeId IN nodeIds | gds.util.asNode(nodeId).name] AS nodeNames,
    costs,
    nodes(path) as path
ORDER BY index| index | sourceNodeName | targetNodeName | totalCost | nodeNames | costs | path |
|---|---|---|---|---|---|---|
0 |
"Kings Cross" |
"Kentish Town" |
3.3 |
["Kings Cross", "Euston", "Camden Town", "Kentish Town"] |
[0.0, 0.7, 2.0, 3.3] |
[Node[0], Node[1], Node[2], Node[4]] |
结果显示了图中 King’s Cross 和 Kentish Town 节点间最短路径的总代价。它还显示了为找到最短路径而遍历的节点 ID 的有序列表,以及已访问节点的累积代价。这可以在 示例图 中进行验证。Cypher Path 对象可以通过 path 返回字段获取。Path 对象包含节点对象以及具有 cost 属性的虚拟关系。
修改(Mutate)
mutate 执行模式会使用新关系更新命名图。每条新关系代表从源节点到目标节点的一条路径。关系类型使用 mutateRelationshipType 选项进行配置。路径总成本使用 totalCost 属性存储。
当多个算法结合使用时,mutate 模式特别有用。
有关 mutate 模式的更多详细信息,请参阅 变更。
mutate 模式运行该算法:MATCH (source:Station {name: 'Kings Cross'}), (target:Station {name: 'Kentish Town'})
CALL gds.shortestPath.astar.mutate('myGraph', {
sourceNode: source,
targetNode: target,
latitudeProperty: 'latitude',
longitudeProperty: 'longitude',
relationshipWeightProperty: 'distance',
mutateRelationshipType: 'PATH'
})
YIELD relationshipsWritten
RETURN relationshipsWritten| relationshipsWritten |
|---|
1 |
执行上述查询后,内存图将更新为类型为 PATH 的新关系。这些新关系将存储一个单一属性 totalCost。
|
即使输入图是无向的,生成的关系也始终是有向的。 |
写入(Write)
write 执行模式使用新关系更新 Neo4j 数据库。每条新关系代表从源节点到目标节点的一条路径。关系类型使用 writeRelationshipType 选项进行配置。路径总成本使用 totalCost 属性存储。中间节点的 ID 使用 nodeIds 属性存储。到达中间节点的累计成本使用 costs 属性存储。
有关 write 模式的更多详细信息,请参阅 写入。
write 模式运行该算法:MATCH (source:Station {name: 'Kings Cross'}), (target:Station {name: 'Kentish Town'})
CALL gds.shortestPath.astar.write('myGraph', {
sourceNode: source,
targetNode: target,
latitudeProperty: 'latitude',
longitudeProperty: 'longitude',
relationshipWeightProperty: 'distance',
writeRelationshipType: 'PATH',
writeNodeIds: true,
writeCosts: true
})
YIELD relationshipsWritten
RETURN relationshipsWritten| relationshipsWritten |
|---|
1 |
上述查询会将一个类型为 PATH 的关系写回 Neo4j。该关系存储了描述路径的三个属性:totalCost、nodeIds 和 costs。
|
即使输入图是无向的,写入的关系也始终是有向的。 |