内存估算
图算法库完全在堆内存上运行,这意味着我们需要将 Neo4j 服务器的堆大小配置得比事务处理工作负载大得多。下图展示了投影图模型如何使用内存。
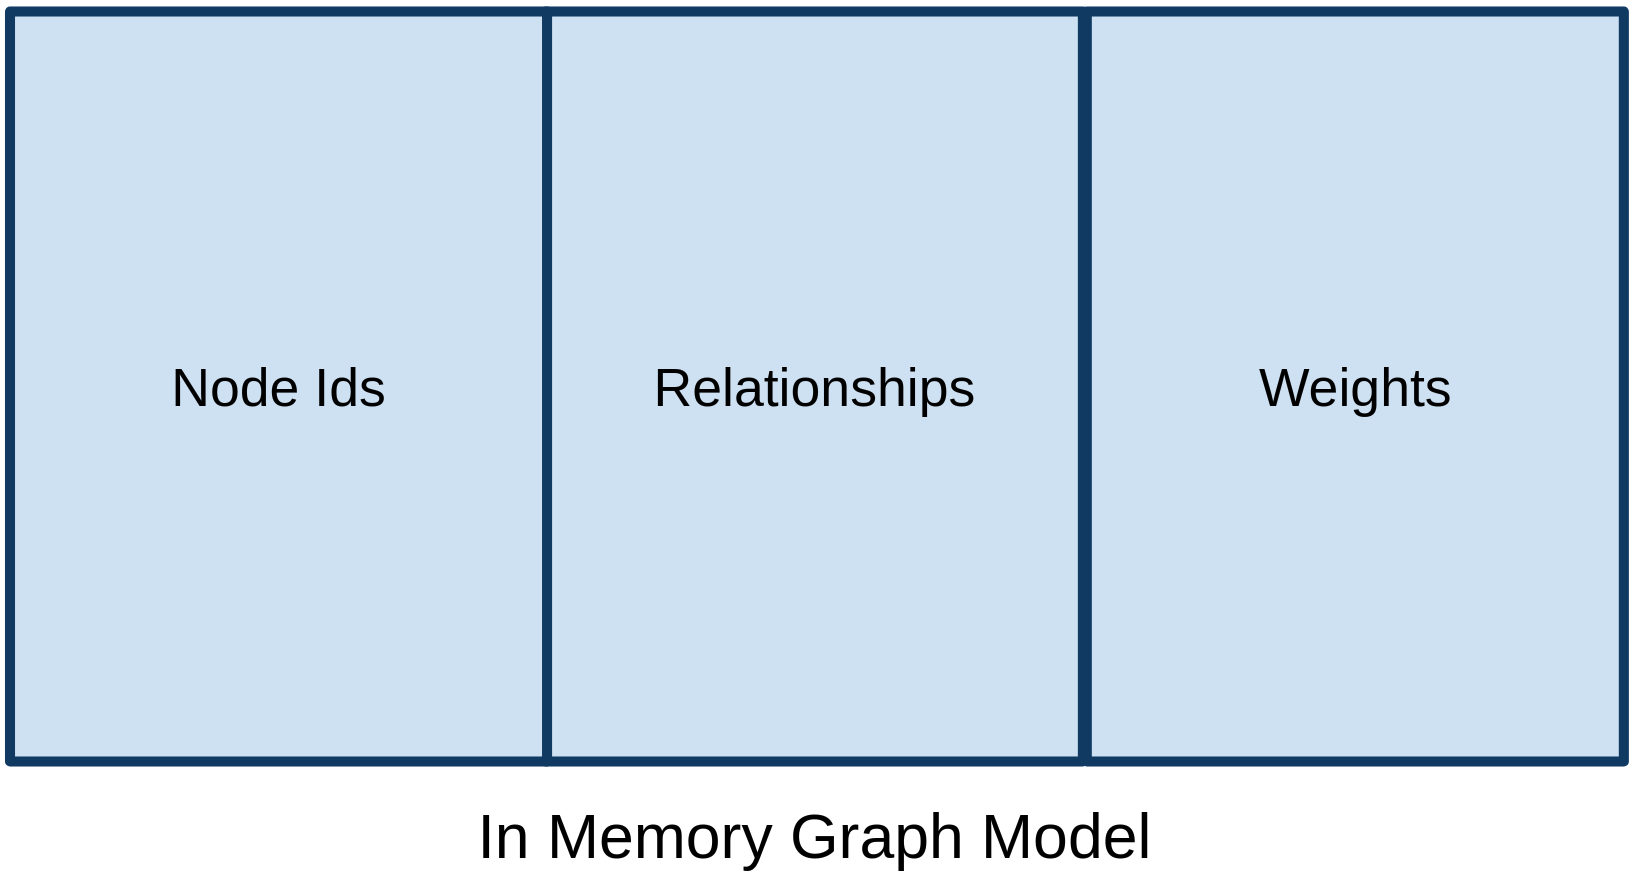
该模型包含三种类型的数据
-
节点 ID - 最高可达 245(“35 万亿”)
-
关系 - 节点 ID 对。如果使用了
orientation: "UNDIRECTED"(无向),关系会被存储两次。 -
权重 - 作为双精度浮点数(每个节点 8 字节)存储在关系旁边的类数组数据结构中
内存配置取决于我们正在使用的图投影。
估算算法的内存需求
在许多用例中,在运行图投影和算法之前先估算其所需内存非常有用,以确保工作负载能够在可用的空闲内存中运行。为此,可以使用 .estimate 模式,它会返回运行图算法所需内存量的估算值。请注意,只有生产就绪(production-ready)级别的算法才保证具有 .estimate 模式。有关更多详细信息,请参阅 语法概述。
CALL gds[.<tier>].<algorithm>.<execution-mode>.estimate(
  graphNameOrConfig: String or Map,
  configuration: Map
) YIELD
  nodeCount: Integer,
  relationshipCount: Integer,
  requiredMemory: String,
  treeView: String,
  mapView: Map,
  bytesMin: Integer,
  bytesMax: Integer,
  heapPercentageMin: Float,
heapPercentageMax: Float| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
graphNameOrConfig |
字符串或映射 |
- |
否 |
投影图的名称或用于投影图的配置。 |
配置 |
Map |
- |
否 |
算法的配置。 |
配置映射(configuration map)接受与被估算算法相同的配置参数。有关更多信息,请参阅特定算法的文档。
与执行算法的过程不同,对于内存估算,可以定义图投影配置。通过这种方式,可以同时测量投影图和执行算法的内存消耗。
| 名称 | 类型 | 描述 |
|---|---|---|
|
整数 |
图中的节点数。 |
|
整数 |
图中的关系总数。 |
|
字符串 |
以人类可读格式给出的所需内存估算值。 |
|
字符串 |
所需内存的更详细表示,包括以人类可读格式对不同组件的估算。 |
|
Map |
所需内存的更详细表示,包括以结构化格式对不同组件的估算。 |
|
整数 |
所需的最小字节数。 |
|
整数 |
所需的最大字节数。 |
|
浮点数 |
所需配置的最大堆内存的最小百分比。 |
|
浮点数 |
所需配置的最大堆内存的最大百分比。 |
图创建配置
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
字符串、字符串列表或映射 |
null |
是 |
通过原生(Native)投影进行匿名图创建时使用的节点投影。 |
|
字符串、字符串列表或映射 |
null |
是 |
通过原生(Native)投影进行匿名图创建时使用的关系投影。 |
|
nodeQuery |
字符串 |
null |
是 |
通过传统 Cypher(Legacy Cypher)投影进行匿名图创建时,用于选择节点的 Cypher 查询。 |
relationshipQuery |
字符串 |
null |
是 |
通过传统 Cypher(Legacy Cypher)投影进行匿名图创建时,用于选择关系的 Cypher 查询。 |
nodeProperties |
字符串、字符串列表或映射 |
null |
是 |
在匿名图创建期间要投影的节点属性。 |
relationshipProperties |
字符串、字符串列表或映射 |
null |
是 |
在匿名图创建期间要投影的关系属性。 |
整数 |
4 [1] |
是 |
用于运行算法的并发线程数。 |
|
字符串 |
内部生成 |
是 |
可以提供一个 ID 以更轻松地跟踪算法的进度。 |
|
布尔值 |
true |
是 |
如果禁用,进度百分比将不会被记录。 |
|
readConcurrency |
整数 |
'concurrency' 的值 |
是 |
创建图时使用的并发线程数。 |
估算图的内存需求
gds.graph.project 过程也支持 .estimate 来仅估算图的内存使用量。这些过程不接受图名称作为第一个参数,因为它们实际上并不投影图。
CALL gds.graph.project.estimate(nodeProjection: String|List|Map, relationshipProjection: String|List|Map, configuration: Map)
YIELD requiredMemory, treeView, mapView, bytesMin, bytesMax, heapPercentageMin, heapPercentageMax, nodeCount, relationshipCount
nodeProjection 和 relationshipProjection 参数遵循与 gds.graph.project 中相同的语法。
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
nodeProjection |
字符串、列表或映射 |
- |
否 |
要估算的节点投影。 |
relationshipProjection |
字符串、列表或映射 |
- |
否 |
要估算的关系投影。 |
配置 |
Map |
{} |
是 |
附加配置,例如并发性。 |
运行 gds.graph.project.estimate 的结果与上述算法内存估算结果形式相同。
也可以通过显式指定其节点和关系数量来估算虚拟图(fictive graph)的内存。使用此功能,可以估算任意大小图的内存消耗。
为实现这一点,请使用以下配置选项
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
nodeCount |
整数 |
0 |
是 |
虚拟图中的节点数。 |
relationshipCount |
整数 |
0 |
是 |
虚拟图中的关系数。 |
在估算虚拟图时,必须指定语法有效的 nodeProjection 和 relationshipProjection。但是,建议在虚拟图情况下两者都指定为 '*',因为这不会干扰上述指定的值。
下面的查询是估算一个包含 100 个节点和 1000 个关系的虚拟图的示例。
CALL gds.graph.project.estimate('*', '*', {
  nodeCount: 100,
  relationshipCount: 1000,
  nodeProperties: 'foo',
  relationshipProperties: 'bar'
})
YIELD requiredMemory, treeView, mapView, bytesMin, bytesMax, nodeCount, relationshipCount| requiredMemory | bytesMin | bytesMax | nodeCount | relationshipCount |
|---|---|---|---|---|
"593 KiB" |
607576 |
607576 |
100 |
1000 |
gds.graph.project.cypher 过程必须执行 nodeQuery 和 relationshipQuery,以便计算图中节点的数量和关系的数量。
CALL gds.graph.project.cypher.estimate(nodeQuery: String, relationshipQuery: String, configuration: Map)
YIELD requiredMemory, treeView, mapView, bytesMin, bytesMax, heapPercentageMin, heapPercentageMax, nodeCount, relationshipCount| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
nodeQuery |
字符串 |
- |
否 |
要估算的节点查询。 |
relationshipQuery |
字符串 |
- |
否 |
要估算的关系查询。 |
配置 |
Map |
{} |
是 |
附加配置,例如并发性。 |
自动估算和执行阻塞
GDS 库中所有支持估算的过程(包括图创建)都会在执行开始时进行估算检查。这包括所有执行模式,但不包括 estimate 过程本身。
如果估算检查确定当前的空闲内存量不足以完成该操作,则该操作将被中止并报告错误。错误信息将包含估算的详细信息以及估算时的空闲内存量。
此堆控制逻辑具有限制性,因为它只会阻塞确定无法放入内存的执行。它不能保证通过堆控制的执行一定能成功而不耗尽内存。因此,在对大型数据集运行算法或图创建之前,先运行估算模式以查看估算的所有细节仍然很有用。
绕过堆控制
有时,如果堆控制过于严格,您可能希望能够绕过它。您可能对自己特定的过程调用在内存方面的表现有深入了解;或者您可能只是想尝试一下,例如因为您收到的内存估算值非常接近系统限制。
针对该用例,我们有 sudo 模式,它允许您手动跳过堆控制并强制运行您的过程。Sudo 模式默认处于关闭状态以保护用户——如果我们能看出您可能长时间运行的过程无法成功完成,我们会快速失败(fail fast)。
要启用 sudo 模式,请在调用过程时添加 sudo 参数。以下是以 sudo 模式调用流行的 Louvain 社区检测算法的示例
CALL gds.louvain.write('myGraph', { writeProperty: 'community', sudo: true })
YIELD communityCount, modularity, modularities
在调用过程时意外启用 sudo 模式导致内存耗尽,不会对您的安装造成重大损坏,但会浪费您的时间。