弱连通分量 (Weakly Connected Components)
简介
弱连通分量 (WCC) 算法用于在有向图和无向图中查找连通的节点集合。如果两个节点之间存在路径,则称它们是连通的。所有相互连通的节点集合构成一个分量。与强连通分量 (SCC) 不同,WCC 不考虑路径中关系的方向。例如,在有向图 (a)→(b) 中,即使不存在有向关系 (b)→(a),a 和 b 也会被归入同一个分量。
WCC 常用于分析的早期阶段,以了解图的结构。利用 WCC 理解图结构,可以随后在确定的簇上独立运行其他算法。
该算法的实现基于以下论文:
语法
本节涵盖执行弱连通分量算法所使用的语法。
CALL Neo4j_Graph_Analytics.graph.wcc(
  'CPU_X64_XS',                    (1)
  {
    ['defaultTablePrefix': '...',] (2)
    'project': {...},              (3)
    'compute': {...},              (4)
    'write':   {...}               (5)
  }
);| 1 | 计算池选择器。 |
| 2 | 表引用的可选前缀。 |
| 3 | 项目配置。 |
| 4 | 计算配置。 |
| 5 | 写入配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
computePoolSelector |
字符串 |
|
否 |
用于运行 WCC 作业的计算池选择器。 |
配置 |
Map |
|
否 |
用于图项目、算法计算和结果回写的配置。 |
配置映射由以下三个条目组成。
| 有关以下项目配置的更多详细信息,请参阅 项目文档。 |
| 名称 | 类型 |
|---|---|
nodeTables |
节点表列表。 |
relationshipTables |
关系类型到关系表的映射。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
resultProperty |
字符串 |
|
是 |
将回写到 Snowflake 数据库的节点属性。 |
relationshipWeightProperty |
字符串 |
|
是 |
用作权重的关系属性名称。如果未指定,算法将作为无权重运行。 |
seedProperty |
字符串 |
|
是 |
用于设置节点的初始分量。属性值必须为数字。 |
阈值 (threshold) |
浮点数 |
|
是 |
关系在计算中被考虑的权重阈值。 |
consecutiveIds |
布尔值 |
|
是 |
用于决定组件标识符是否映射到连续 ID 空间的标志(需要额外的内存)。 |
| 关于下文写入配置的更多详细信息,请参考 写入文档。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
nodeLabel |
字符串 |
|
否 |
内存中图中用于写入节点属性的节点标签。 |
nodeProperty |
字符串 |
|
是 |
将回写到 Snowflake 数据库的节点属性。 |
outputTable |
字符串 |
|
否 |
Snowflake 数据库中写入节点属性的表。 |
示例
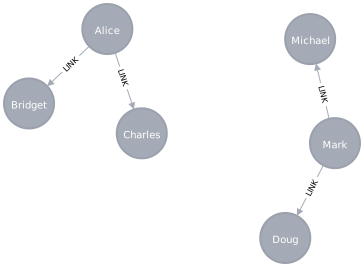
在本节中,我们将展示在具体图上运行弱连通分量算法的示例。目的是为了说明结果的样子,并为在实际场景中使用该算法提供指导。我们将在一个由少量节点按特定模式连接而成的小型用户网络图上进行演示。示例图如下所示:
CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.USERS (NODEID VARCHAR);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.USERS VALUES
  ('Alice'),
  ('Bridget'),
  ('Charles'),
  ('Doug'),
  ('Mark'),
  ('Michael');

CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.LINKS (SOURCENODEID VARCHAR, TARGETNODEID VARCHAR, WEIGHT FLOAT);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.LINKS VALUES
  ('Alice', 'Bridget', 0.5),
  ('Alice', 'Charles', 4),
  ('Mark',  'Doug',    1.1),
  ('Mark',  'Michael', 2);
该图有两个连通分量,每个分量有三个节点。连接各分量内节点的边具有一个 weight(权重)属性,该属性决定了关系的强度。
在接下来的示例中,我们将演示如何在上述图上使用弱连通分量算法。
运行作业
运行 WCC 作业涉及三个步骤:投影 (Project)、计算 (Compute) 和写入 (Write)。
要运行查询,需要为应用程序、您的消费者角色和您的环境设置必要的权限。请参阅 入门 页面以了解更多信息。
我们还假设应用程序名称为默认的 Neo4j_Graph_Analytics。如果您在安装过程中选择了不同的应用程序名称,请将其替换为该名称。
CALL Neo4j_Graph_Analytics.graph.wcc('CPU_X64_XS', {
  'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
  'project': {
    'nodeTables': ['USERS'],
    'relationshipTables': {
      'LINKS': {
        'sourceTable': 'USERS',
        'targetTable': 'USERS'
      }
    }
  },
  'compute': {},
  'write': [
    {
      'nodeLabel': 'USERS',
      'outputTable': 'USERS_COMPONENTS'
    }
  ]
});| JOB_ID | JOB_STATUS | JOB_START | JOB_END | JOB_RESULT |
|---|---|---|---|---|
job_492026bbeaa6422eb4502a18def04cd6 |
SUCCESS |
2025-04-30 13:53:53.702000 |
2025-04-30 13:54:00.716000 |
 {
  "project_1": {
    "graphName": "snowgraph",
    "nodeCount": 6,
    "nodeLabels": ...,
    "nodeMillis": 212,
    "relationshipCount": 4,
    "relationshipMillis": 519,
    "relationshipTypes": ...,
    "totalMillis": 731
  },
  "wcc_1": {
    "componentCount": 2,
    "componentDistribution": {
      "max": 3,
      "mean": 3,
      "min": 3,
      "p1": 3,
      "p10": 3,
      "p25": 3,
      "p5": 3,
      "p50": 3,
      "p75": 3,
      "p90": 3,
      "p95": 3,
      "p99": 3,
      "p999": 3
    },
    "computeMillis": 9,
    "configuration": {
      "concurrency": 2,
      "consecutiveIds": false,
      "resultProperty": "component",
      "nodeLabels": ["*"],
      "relationshipTypes": ["*"],
      "seedProperty": null,
      "threshold": 0
    }
  },
  "write_node_property_1": {
    "nodeLabel": "USERS",
    "nodeProperty": "component",
    "outputTable": "EXAMPLE_DB.DATA_SCHEMA.USERS_COMPONENTS",
    "rowsWritten": 6,
    "writeMillis": 2532
  }
} |
返回的结果包含有关作业执行和结果分布的信息。此外,每个节点的分量 ID 已写回 Snowflake 数据库。我们可以通过如下方式进行查询:
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.USERS_COMPONENTS;| NODEID | COMPONENT |
|---|---|
Alice |
0 |
Bridget |
0 |
Charles |
0 |
Doug |
3 |
Mark |
3 |
Michael |
3 |
结果显示该算法识别出了两个分量。这一点可以在示例图中得到验证。
|
实际的分量 ID 可能会有所不同,因为内存中图投影的节点顺序无法保证。对于这种情况,得到相反的解也是合理的,例如当我们的社区 |
加权 WCC
通过配置算法使用权重,我们可以增加算法计算分量分配时的粒度。我们通过 relationshipWeightProperty 配置参数指定属性键来实现这一点。此外,我们可以为权重值指定一个阈值。这样,只有大于阈值的权重才会被算法考虑。我们通过 threshold 配置参数指定该阈值。
如果关系没有指定的权重属性,算法将默认使用零作为权重值。
CALL Neo4j_Graph_Analytics.graph.wcc('CPU_X64_XS', {
  'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
  'project': {
    'nodeTables': ['USERS'],
    'relationshipTables': {
      'LINKS': {
        'sourceTable': 'USERS',
        'targetTable': 'USERS'
      }
    }
  },
  'compute': {
      'relationshipWeightProperty': 'WEIGHT',
      'threshold': 1.0
  },
  'write': [
    {
      'nodeLabel': 'USERS',
      'outputTable': 'USERS_COMPONENTS'
    }
  ]
});| JOB_ID | JOB_STATUS | JOB_START | JOB_END | JOB_RESULT |
|---|---|---|---|---|
job_d4f7ab2a37224183a0f4b3fd56003919 |
SUCCESS |
2025-06-18 12:10:52.657 |
2025-06-18 12:10:57.709 |
 {
  "project_1": {
    "graphName": "snowgraph",
    "nodeCount": 6,
    "nodeLabels": ...,
    "nodeMillis": 150,
    "relationshipCount": 4,
    "relationshipMillis": 388,
    "relationshipTypes": ...,
    "totalMillis": 538
  },
  "wcc_1": {
    "componentCount": 3,
    "componentDistribution": {
      "max": 3,
      "mean": 2,
      "min": 1,
      "p1": 1,
      "p10": 1,
      "p25": 1,
      "p5": 1,
      "p50": 2,
      "p75": 3,
      "p90": 3,
      "p95": 3,
      "p99": 3,
      "p999": 3
    },
    "computeMillis": 21,
    "configuration": {
      "concurrency": 2,
      "consecutiveIds": false,
      "jobId": "a4a2c46b-9723-4f17-badd-b052707d5a90",
      "logProgress": true,
      "resultProperty": "component",
      "nodeLabels": ["*"],
      "relationshipTypes": ["*"],
      "relationshipWeightProperty": "WEIGHT",
      "seedProperty": null,
      "sudo": false,
      "threshold": 1
    },
    "mutateMillis": 3,
    "nodePropertiesWritten": 6,
    "postProcessingMillis": 35,
    "preProcessingMillis": 10
  },
  "write_node_property_1": {
    "nodeLabel": "USERS",
    "nodeProperty": "component",
    "outputTable": "EXAMPLE_DB.DATA_SCHEMA.USERS_COMPONENTS",
    "rowsWritten": 6,
    "writeMillis": 1940
  }
} |
从下面的结果中可以看出,名为“Bridget”的节点现在处于它自己的分量中,这是因为它的关系权重小于所配置的阈值,从而被忽略了。
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.USERS_COMPONENTS;| NODEID | COMPONENT |
|---|---|
Alice |
0 |
Bridget |
1 |
Charles |
0 |
Doug |
3 |
Mark |
3 |
Michael |
3 |
|
实际的分量 ID 可能会有所不同,因为内存中图投影的节点顺序无法保证。对于这种情况,得到相反的解也是合理的,例如当我们的社区 |
种子分量 (Seeded components)
可以使用 seedProperty 配置参数为节点定义预备分量 ID。如果我们希望保留之前运行的结果,并且已知没有分量因删除关系而分裂,那么此功能非常有用。属性值必须为数字。
算法首先检查节点是否分配了种子分量 ID。如果存在,则使用该分量 ID。否则,为节点分配一个新的唯一分量 ID。
一旦每个节点都属于一个分量,算法就会合并连通节点的分量。当合并分量时,结果分量始终是分量 ID 较小的那个。请注意,为了保留种子值,不能将 consecutiveIds 配置选项与种子设定结合使用。
|
算法假设具有相同种子值的节点确实属于同一个分量。如果不同分量中的任意两个节点具有相同的种子,则行为是未定义的。在这种情况下,建议在不使用种子的情况下运行 WCC。 |
为了在实践中演示这一点,我们将经过几个步骤:
-
我们将设置新的输入,其中一些节点具有分量 ID,而另一些则没有。
-
我们将运行带有指向分量 ID 的种子属性参数的 WCC。
-
我们将观察到现有的分量 ID 被保留,并且新节点被添加到现有的分量中。
从输入数据开始:Mats 是一个没有分量种子的高新节点。但他与 Bridget 相连。
CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.USERS (NODEID VARCHAR, COMPONENTID NUMBER);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.USERS VALUES
  ('Alice', 2),
  ('Bridget', 0),
  ('Charles', 2),
  ('Doug', 1),
  ('Mark', 1),
  ('Mats', NULL),
  ('Michael', 1);

CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.LINKS (SOURCENODEID VARCHAR, TARGETNODEID VARCHAR, WEIGHT FLOAT);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.LINKS VALUES
  ('Alice', 'Bridget', 0.5),
  ('Alice', 'Charles', 4),
  ('Bridget', 'Mats', 2),
  ('Mark',  'Doug',    1.1),
  ('Mark',  'Michael', 2);
我们现在可以在新的输入数据上运行 WCC 作业。
CALL Neo4j_Graph_Analytics.graph.wcc('CPU_X64_XS', {
  'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
  'project': {
    'nodeTables': ['USERS'],
    'relationshipTables': {
      'LINKS': {
        'sourceTable': 'USERS',
        'targetTable': 'USERS'
      }
    }
  },
  'compute': {
      'relationshipWeightProperty': 'WEIGHT',
      'seedProperty': 'COMPONENTID',
      'threshold': 1.0
  },
  'write': [
    {
      'nodeLabel': 'USERS',
      'outputTable': 'USERS_COMPONENTS'
    }
  ]
});| JOB_ID | JOB_STATUS | JOB_START | JOB_END | JOB_RESULT |
|---|---|---|---|---|
job_5c839fe33a934e7dbf80c891a28ac852 |
SUCCESS |
2025-06-19 08:10:52.076 |
2025-06-19 08:10:57.285 |
 {
  "project_1": {
    "graphName": "snowgraph",
    "nodeCount": 7,
    "nodeLabels": ...,
    "nodeMillis": 150,
    "relationshipCount": 5,
    "relationshipMillis": 286,
    "relationshipTypes": ...,
    "totalMillis": 436
  },
  "wcc_1": {
    "componentCount": 3,
    "componentDistribution": {
      "max": 3,
      "mean": 2.3333333333333335,
      "min": 2,
      "p1": 2,
      "p10": 2,
      "p25": 2,
      "p5": 2,
      "p50": 2,
      "p75": 3,
      "p90": 3,
      "p95": 3,
      "p99": 3,
      "p999": 3
    },
    "computeMillis": 10,
    "configuration": {
      "concurrency": 2,
      "consecutiveIds": false,
      "jobId": "job_5c839fe33a934e7dbf80c891a28ac852",
      "logProgress": true,
      "resultProperty": "component",
      "nodeLabels": ["*"],
      "relationshipTypes": ["*"],
      "relationshipWeightProperty": "WEIGHT",
      "seedProperty": "COMPONENTID",
      "sudo": false,
      "threshold": 1
    },
    "mutateMillis": 1,
    "nodePropertiesWritten": 7,
    "postProcessingMillis": 23,
    "preProcessingMillis": 16
  },
  "write_node_property_1": {
    "nodeLabel": "USERS",
    "nodeProperty": "component",
    "outputTable": "EXAMPLE_DB.DATA_SCHEMA.USERS_COMPONENTS",
    "rowsWritten": 7,
    "writeMillis": 1863
  }
} |
我们看到新节点 Mats 由于与 Bridget 的连接,被放入了与她相同的分量,并保留了她旧的分量标签 0。
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.USERS_COMPONENTS;| NODEID | COMPONENT |
|---|---|
Alice |
2 |
Bridget |
0 |
Charles |
2 |
Doug |
1 |
Mark |
1 |
Mats |
0 |
Michael |
1 |
结果显示,尽管在投影时没有 seedProperty,节点“Mats”仍被分配到了与节点“Bridget”相同的分量中。这是正确的,因为这两个节点是连通的。