Dijkstra 源目标最短路径
简介
Dijkstra 最短路径算法用于计算节点间的最短路径。该算法支持带有正权重关系(边)的加权图。Dijkstra 源-目标算法用于计算一个源节点与一系列目标节点之间的最短路径,或计算表中指定的多个源-目标对之间的最短路径。若要计算从一个源节点到所有可达节点的所有路径,可以使用 Dijkstra 单源最短路径。
Graph Analytics for Snowflake 的实现基于原始描述,并使用二叉堆作为优先队列。
语法
本节涵盖了执行 Dijkstra 算法所使用的语法。
CALL Neo4j_Graph_Analytics.graph.dijkstra(
  'CPU_X64_XS',                    (1)
  {
    ['defaultTablePrefix': '...',] (2)
    'project': {...},              (3)
    'compute': {...},              (4)
    'write':   {...}               (5)
  }
);| 1 | 计算池选择器。 |
| 2 | 表引用的可选前缀。 |
| 3 | 项目配置。 |
| 4 | 计算配置。 |
| 5 | 写入配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
computePoolSelector |
字符串 |
|
否 |
用于运行 Dijkstra 源-目标任务的计算池选择器。 |
配置 |
Map |
|
否 |
用于图项目、算法计算和结果回写的配置。 |
配置映射由以下三个条目组成。
| 有关以下项目配置的更多详细信息,请参阅 项目文档。 |
| 名称 | 类型 |
|---|---|
nodeTables |
节点表列表。 |
relationshipTables |
关系类型到关系表的映射。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
sourceNode |
整数或字符串 |
|
否1 |
源节点标识符。 |
sourceNodeTable |
字符串 |
|
否1 |
用于映射源节点标识符的表。 |
targetNode |
整数或字符串 |
|
否1 |
目标节点标识符。 |
targetNodeTable |
字符串 |
|
否1 |
用于映射目标节点标识符的表。 |
targetNodes |
整数或字符串列表 |
|
否1 |
目标节点标识符列表。 |
targetNodesTable |
字符串 |
|
否1 |
用于映射目标节点标识符的表。 |
sourceTargetNodePairsTable |
字符串 |
|
否1 |
包含多个源-目标节点对的表,该表具有 |
resultProperty |
字符串 |
|
是 |
将回写到 Snowflake 数据库的关系属性。 |
resultRelationshipType |
字符串 |
|
是 |
用于回写到 Snowflake 数据库的关系类型。 |
relationshipWeightProperty |
字符串 |
|
是 |
用作权重的关系属性名称。如果未指定,算法将作为无权重运行。 |
1 源-目标配对必须通过以下三种方式之一进行指定:
-
使用
sourceNode、sourceNodeTable和targetNode、targetNodeTable来指定单个源-目标对。 -
使用
sourceNode、sourceNodeTable和targetNodes、targetNodesTable来指定单个源节点与多个目标节点。 -
使用
sourceTargetNodePairsTable、sourceNodeTable和targetNodeTable来从表中指定多个源-目标对。
| 关于下文写入配置的更多详细信息,请参考 写入文档。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
sourceLabel |
字符串 |
|
否 |
内存图中待回写关系起始节点的节点标签。 |
targetLabel |
字符串 |
|
否 |
内存图中待回写关系结束节点的节点标签。 |
outputTable |
字符串 |
|
否 |
关系写入的 Snowflake 数据库表。 |
关系类型 (relationshipType) |
字符串 |
|
是 |
将回写到 Snowflake 数据库的关系类型。 |
relationshipProperty |
字符串 |
|
是 |
将回写到 Snowflake 数据库的关系属性。 |
示例
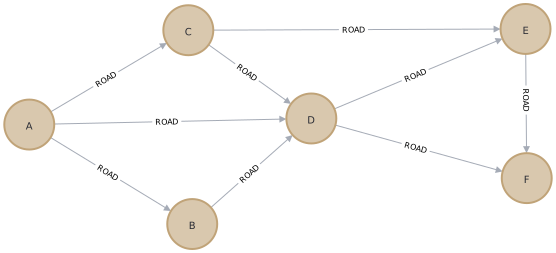
现在,我们将研究如何将 Dijkstra 算法应用于道路网络。
CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.LOCATIONS (NODEID VARCHAR);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.LOCATIONS VALUES
  ('A'),
  ('B'),
  ('C'),
  ('D'),
  ('E'),
  ('F');

CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.ROADS (SOURCENODEID VARCHAR, TARGETNODEID VARCHAR, COST FLOAT);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.ROADS VALUES
  ('A', 'B',  50),
  ('A', 'C',  50),
  ('A', 'D', 100),
  ('B', 'D',  40),
  ('C', 'D',  40),
  ('C', 'E',  80),
  ('D', 'E',  30),
  ('D', 'F',  80),
  ('E', 'F',  40);
我们使用上述表格作为输入,并将其投影到内存图(in-memory graph)中。该图构建了一个包含各地点间道路的交通网络。与现实世界一样,图中的道路具有不同的长度。这些长度由 cost 关系属性表示。
在以下示例中,我们将演示如何使用此图运行 Dijkstra 最短路径算法。
运行任务
运行 Dijkstra 任务涉及三个步骤:投影 (Project)、计算 (Compute) 和写入 (Write)。
CALL Neo4j_Graph_Analytics.graph.dijkstra('CPU_X64_XS', {
    'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
    'project': {
        'nodeTables': [ 'LOCATIONS' ],
        'relationshipTables': {
            'ROADS': {
                'sourceTable': 'LOCATIONS',
                'targetTable': 'LOCATIONS'
            }
        }
    },
    'compute': {
        'sourceNode': 'A',
        'sourceNodeTable': 'LOCATIONS',
        'targetNode': 'E',
        'targetNodeTable': 'LOCATIONS',
        'relationshipWeightProperty': 'COST'
    },
    'write': [{
        'sourceLabel': 'LOCATIONS',
        'targetLabel': 'LOCATIONS',
        'outputTable': 'PATHS'
    }]
});| JOB_ID | JOB_STATUS | JOB_START | JOB_END | JOB_RESULT |
|---|---|---|---|---|
job_cec5b6b71a2d4d8dad94f4a653422d63 |
SUCCESS |
2025-05-06 10:09:49.579000 |
2025-05-06 10:09:58.703000 |
{
  "dijkstra_1": {
    "computeMillis": 13,
    "configuration": {
      "concurrency": 6,
      "resultRelationshipType": "PATH",
      "nodeLabels": [
        "*"
      ],
      "relationshipTypes": [
        "*"
      ],
      "relationshipWeightProperty": "COST",
      "sourceNode": "A",
      "sourceNodeTable": "EXAMPLE_DB.DATA_SCHEMA.LOCATIONS",
      "targetNode": "E",
      "targetNodes": []
    }
  },
  "project_1": {
    "graphName": "snowgraph",
    "nodeCount": 6,
    "nodeLabels": ...,
    "nodeMillis": 393,
    "relationshipCount": 9,
    "relationshipMillis": 419,
    "relationshipTypes": ...,
    "totalMillis": 812
  },
  "write_relationship_type_1": {
    "outputTable": "EXAMPLE_DB.DATA_SCHEMA.PATHS",
    "relationshipProperty": "[SOURCENODEID, TARGETNODEID, NODEIDS, NODELABELS, COSTS, TOTALCOST]",
    "relationshipType": "PATH",
    "rowsWritten": 0,
    "writeMillis": 1725
  }
} |
返回的结果包含有关任务执行的信息。此外,最短路径已写回 Snowflake 数据库。我们可以像这样进行查询
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.PATHS;这显示了存储在数据库中的计算结果
| SOURCENODEID | TARGETNODEID | NODEIDS | NODELABELS | COSTS | TOTALCOST |
|---|---|---|---|---|---|
A |
E |
["A", "B", "D", "E"] |
["LOCATIONS", "LOCATIONS", "LOCATIONS", "LOCATIONS"] |
[0, 50, 90, 120] |
120 |
结果显示了节点 A 和节点 E 之间最短路径的总成本。它还显示了遍历寻找最短路径所经过的有序节点 ID 列表(及其标签),以及所访问节点的累积成本。这可以在示例图中进行验证。
在下面的示例中,我们将演示如何针对一个源节点和一系列目标节点,使用此图来应用 Dijkstra 最短路径算法。
CALL Neo4j_Graph_Analytics.graph.dijkstra('CPU_X64_XS', {
    'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
    'project': {
        'nodeTables': [ 'LOCATIONS' ],
        'relationshipTables': {
            'ROADS': {
                'sourceTable': 'LOCATIONS',
                'targetTable': 'LOCATIONS'
            }
        }
    },
    'compute': {
        'sourceNode': 'A',
        'sourceNodeTable': 'LOCATIONS',
        'targetNodes': ['E', 'C'],
        'targetNodesTable': 'LOCATIONS',
        'relationshipWeightProperty': 'COST'
    },
    'write': [{
        'sourceLabel': 'LOCATIONS',
        'targetLabel': 'LOCATIONS',
        'outputTable': 'PATHS'
    }]
});
返回的结果包含有关任务执行的信息。此外,最短路径已写回 Snowflake 数据库。我们可以像这样进行查询
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.PATHS;这显示了存储在数据库中的计算结果
| SOURCENODEID | TARGETNODEID | NODEIDS | NODELABELS | COSTS | TOTALCOST |
|---|---|---|---|---|---|
A |
E |
["A", "B", "D", "E"] |
["LOCATIONS", "LOCATIONS", "LOCATIONS", "LOCATIONS"] |
[0, 50, 90, 120] |
120 |
A |
C |
["A", "C"] |
["LOCATIONS", "LOCATIONS"] |
[0, 50] |
50 |
结果显示了节点 A 与节点 E 以及节点 A 与节点 C 之间最短路径的总成本。
通过表格中的源-目标对运行任务
Dijkstra 算法可以通过使用 sourceTargetNodePairsTable 参数在单次执行中处理多个源-目标对。这对于需要查找许多不同节点对之间最短路径的批处理场景特别有用。
首先,创建一个包含源-目标节点对的表:
CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.NODE_PAIRS (
    SOURCENODEID VARCHAR,
    TARGETNODEID VARCHAR
);

INSERT INTO EXAMPLE_DB.DATA_SCHEMA.NODE_PAIRS VALUES
    ('A', 'E'),
    ('B', 'F'),
    ('C', 'D');
配对表必须恰好包含两列:
-
SOURCENODEID:源节点标识符 -
TARGETNODEID:目标节点标识符
这些列的数据类型必须与图中节点的标识符相匹配。
CALL Neo4j_Graph_Analytics.graph.dijkstra('CPU_X64_XS', {
    'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
    'project': {
        'nodeTables': [ 'LOCATIONS' ],
        'relationshipTables': {
            'ROADS': {
                'sourceTable': 'LOCATIONS',
                'targetTable': 'LOCATIONS'
            }
        }
    },
    'compute': {
        'sourceTargetNodePairsTable': 'NODE_PAIRS',
        'sourceNodeTable': 'LOCATIONS',
        'targetNodeTable': 'LOCATIONS',
        'relationshipWeightProperty': 'COST'
    },
    'write': [{
        'sourceLabel': 'LOCATIONS',
        'targetLabel': 'LOCATIONS',
        'outputTable': 'MULTIPLE_PATHS'
    }]
});
使用 sourceTargetNodePairsTable 时:
-
sourceNode和targetNode参数会被忽略 -
算法会读取指定表中的所有行
-
对于每一行,它都会计算从
SOURCENODEID到TARGETNODEID的最短路径 -
所有结果都会被写入同一个输出表中
-
结果表中的行遵循源-目标配对表的相同顺序,但仅在两个节点间存在路径时才会产生结果
-
所有计算都使用相同的投影图
-
在将结果写入结果表之前,所有独立的结果都会保留在内存中
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.PATHS_MULTIPLE ORDER BY SOURCENODEID, TARGETNODEID;| SOURCENODEID | TARGETNODEID | NODEIDS | NODELABELS | COSTS | TOTALCOST |
|---|---|---|---|---|---|
A |
E |
["A", "B", "D", "E"] |
["LOCATIONS", "LOCATIONS", "LOCATIONS", "LOCATIONS"] |
[0, 50, 90, 120] |
120 |
B |
F |
["B", "D", "E", "F"] |
["LOCATIONS", "LOCATIONS", "LOCATIONS", "LOCATIONS"] |
[0, 40, 70, 110] |
110 |
C |
D |
["C", "D"] |
["LOCATIONS", "LOCATIONS"] |
[0, 40] |
40 |
输出表为配对表中的每一对源-目标节点包含一行,显示最短路径及其总成本。