过滤后的 K-近邻
简介
“过滤 K-近邻”算法在 K-近邻 (K-Nearest Neighbors) 算法的基础上,增加了对源节点、目标节点或两者的过滤功能。它计算图中被过滤节点对之间的距离值,并在每个节点与其过滤集合中的 k 个最近邻居之间创建新的关系。距离基于节点属性进行计算。
与标准 K-近邻算法一样,输入是一个同构图,任何节点标签或关系类型信息都会被忽略。该图不需要是连通的。实际上,除了使用随机游走采样(如果使用了该初始采样选项)外,节点之间现有的关系将被忽略。新的关系是在每个节点与其过滤候选集中的 k 个最近邻居之间创建的。
“过滤 K-近邻”算法比较每个节点的给定属性。在应用过滤的情况下,从过滤后的候选集中选择属性最相似的 k 个节点作为 k-近邻。
该算法的操作方式与标准 KNN 类似,使用相同的基于迭代的细化过程。初始邻居集是从过滤后的候选集中随机挑选的,并在多次迭代中进行验证和细化。迭代次数受到配置参数 maxIterations 的限制。如果邻居列表的变化仅在微小范围内,算法可能会提前停止,这可以通过配置参数 deltaThreshold 进行控制。
该特定实现基于 Wei Dong 等人撰写的 《通用相似度度量的有效 k-近邻图构建》,并增加了过滤功能。算法没有将每个节点与所有其他节点进行比较,而是基于“节点的邻居的邻居很可能已经是最近邻居”的假设来选择可能的邻居。该算法相对于节点数呈准线性扩展,而不是平方级。
此外,该算法在每次迭代中只比较所有可能邻居的一个样本,假设最终会看到所有可能的邻居。这可以通过配置参数 sampleRate 来控制。
-
有效的采样率必须在 0(不含)到 1(含)之间。
-
默认值为
0.5。 -
此参数用于控制准确性和运行时性能之间的权衡。
-
较高的采样率会提高结果的准确性。
-
算法也将需要更多内存并需要更长的计算时间。
-
-
较低的采样率会提高运行时性能。
-
比较中可能会错过一些潜在节点,因此它们可能不会包含在结果中。
-
当遇到的邻居与已知最不相似的邻居具有相同的相似度时,随机选择保留哪个节点可以降低某些邻域未被探索的风险。此行为由配置参数 perturbationRate 控制。
算法的输出是节点与其 k-近邻之间的新关系。相似度得分通过关系属性表示。
有关基础算法的更多信息,请参阅
过滤类型
“过滤 K-近邻”算法运行在源节点、目标节点以及它们之间持有相似度得分或距离的关系构成的环境中。
就像 K-近邻算法一样,带有过滤的输出是节点与其 k-近邻之间的新关系。相似度得分通过关系属性表示。
“过滤 K-近邻”允许您控制关系两端的节点,使您无需自行过滤大量结果集,从而更好地控制输出量。
源节点过滤
对于某些用例,您可能希望限制可以作为源节点的节点集,或作为源节点的节点类型。这就是源节点过滤。您需要的是源自这些特定节点或特定类型节点的最佳评分关系。
可以通过在计算配置中提供节点标签,或者在提供源节点表的同时提供特定的节点 ID 来指定源节点过滤器。
目标节点过滤
与源节点一样,有时您也希望限制可以作为目标节点的节点集或节点类型,即目标节点过滤。针对给定的源节点,计算出的最佳评分关系是指目标节点来自指定集合或属于指定类型的关系。
可以通过在计算配置中提供节点标签,或者在提供目标节点表的同时提供特定的节点 ID 来指定目标节点过滤器。
目标节点过滤的种子填充 (Seeding)
目标节点过滤的另一个用例是,您绝对希望产生 k 个结果。您希望用关系填满一个固定大小的桶。您希望算法能找到足够多高评分的关系,但作为一种保险策略,您可以使用任意关系来“保证”填满 k 个结果的桶。
就像 K-近邻算法不能保证一定找到 k 个结果一样,“过滤 K-近邻”算法也不能严格保证找到 k 个结果。但是,如果您采用种子填充,获得结果的机会会大大增加。事实上,有了种子填充,唯一不会得到 k 个结果的情况是图中不存在 k 个目标节点。
现在,任意填充结果的质量是未知的。这与 similarityCutoff(相似度截止值)参数如何协调?我们选择的语义是:种子填充会覆盖相似度截止值。因此,您可能会得到相似度低于截止值的结果,但可以保证至少会有 k 个结果。
种子填充是一个布尔属性,您可以选择开启或关闭(默认为关闭)。
|
您可以混合使用源节点过滤、目标节点过滤和种子填充来实现您的目标。 |
相似度度量
“过滤 KNN”算法中使用的相似度度量取决于配置的节点属性类型。过滤 KNN 支持标量数值和数字列表,使用与标准 KNN 算法相同的度量标准。

整数列表
当属性为整数列表时,可以使用 Jaccard 相似度或重叠系数来衡量相似度。
- Jaccard 相似度
-
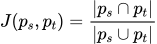 图 2. 交集大小除以并集大小
- 重叠系数
-
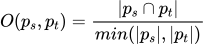 图 3. 交集大小除以最小集合的大小
这两种度量给出的分数范围都在 [0, 1],不需要进行归一化。当未指定度量标准时,Jaccard 相似度是比较整数列表的默认选项。
浮点数列表
当属性为浮点数列表时,计算两个节点之间的相似度有三种替代方案。
默认使用的度量是余弦相似度。
- 余弦相似度
-
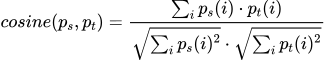 图 4. 向量的点积除以它们长度的乘积
请注意,上述公式给出的得分范围是 [-1, 1]。通过执行 score = (score + 1) / 2,将得分归一化到 [0, 1] 的范围。
另外两种度量包括 Pearson 相关系数和归一化欧几里得相似度。
- Pearson 相关系数
-
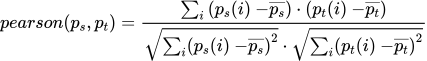 图 5. 协方差除以标准差的乘积
如上所述,该公式给出的分数范围在 [-1, 1],同样被归一化到 [0, 1] 的范围。
- 欧几里得相似度
-
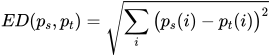 图 6. 每对元素之差的平方和的平方根
该公式的结果是一个非负值,但不一定被限制在 [0, 1] 范围内。为了将数字限制在此范围内并获得相似度分数,我们返回 score = 1 / (1 + distance),即我们执行与标量值情况相同的归一化。
多个属性
最后,当指定了多个属性时,两个邻居的相似度是各个属性相似度的平均值,即这些数值的简单平均值,每个数值都在 [0, 1] 范围内,总得分也保持在 [0, 1] 范围内。
|
这种平均值的有效性高度依赖于上下文,因此在将其应用于您的数据领域时要小心。 |
节点属性和度量配置
要使用的节点属性和度量通过 nodeProperties 配置参数指定。必须至少指定一个节点属性。
此参数接受以下之一
单个属性名称 |
|
属性键到度量的映射 (Map) |
nodeProperties: {
    embedding: 'COSINE',
    age: 'DEFAULT',
    lotteryNumbers: 'OVERLAP'
}
|
字符串和/或映射的列表 |
nodeProperties: [
    {embedding: 'COSINE'},
    'age',
    {lotteryNumbers: 'OVERLAP'}
]
|
按类型划分的可用度量如下
| type | 度量 |
|---|---|
整数列表 |
|
浮点数列表 |
|
对于任何属性类型,也可以指定 DEFAULT 以使用默认度量。对于标量数字,只有默认度量。
配置过滤器和种子填充
您应参考 K-近邻配置 以获取标准配置选项。
源节点过滤器可以通过以下两种方式之一指定:
-
使用带有节点标签字符串的
sourceNodeFilter -
使用带有节点 ID 列表的
sourceNodeFilter,并结合sourceNodeTable指定包含这些节点的表
目标节点过滤器可以通过以下两种方式之一指定:
-
使用带有节点标签字符串的
targetNodeFilter -
使用带有节点 ID 列表的
targetNodeFilter,并结合targetNodeTable指定包含这些节点的表
种子填充可以通过计算配置中的 seedTargetNodes 配置参数启用。它默认为 false。
初始邻居采样
算法首先从过滤后的候选集中为每个节点随机挑选 k 个邻居。这种随机采样有两种方式可供选择。
- 均匀 (Uniform)
-
每个节点的初始
k个邻居是从所有符合过滤条件的节点中均匀随机选择的。这是进行初始采样的经典方式,也是算法的默认设置。请注意,此方法实际上并不使用输入图的拓扑结构。 - 随机游走 (Random Walk)
-
我们从每个节点进行一次深度偏向的随机游走,并选择在该游走中访问到的、符合过滤条件的前
k个唯一节点作为初始随机邻居。如果在内部定义的O(k)次随机游走步骤后,没有访问到k个符合过滤条件的唯一邻居,我们将使用上述均匀采样法填充剩余的邻居。随机游走法利用了输入图的拓扑结构,如果拓扑上接近的节点之间更有可能找到良好的相似度得分,则该方法可能更合适。
|
所使用的随机游走在深度上具有偏向性,即它更倾向于远离之前访问过的节点,而不是回到该节点或回到与之等距的节点。这种偏向的直觉是,后续比较邻居的邻居的迭代很可能会覆盖每个节点的扩展(拓扑)邻域。 |
语法
本节涵盖执行“过滤 K-近邻”算法所使用的语法。
CALL Neo4j_Graph_Analytics.graph.knn_filtered(
  'CPU_X64_XS',                    (1)
  {
    ['defaultTablePrefix': '...',] (2)
    'project': {...},              (3)
    'compute': {...},              (4)
    'write':   {...}               (5)
  }
);| 1 | 计算池选择器。 |
| 2 | 表引用的可选前缀。 |
| 3 | 项目配置。 |
| 4 | 计算配置。 |
| 5 | 写入配置。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
computePoolSelector |
字符串 |
|
否 |
用于运行“过滤 KNN”作业的计算池选择器。 |
配置 |
Map |
|
否 |
用于图项目、算法计算和结果回写的配置。 |
配置映射由以下三个条目组成。
| 有关以下项目配置的更多详细信息,请参阅 项目文档。 |
| 名称 | 类型 |
|---|---|
nodeTables |
节点表列表。 |
relationshipTables |
关系类型到关系表的映射。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
resultProperty |
字符串 |
|
是 |
将回写到 Snowflake 数据库的关系属性。 |
resultRelationshipType |
字符串 |
|
是 |
用于回写到 Snowflake 数据库的关系类型。 |
nodeProperties |
字符串或 Map 或字符串/Map 的列表 |
|
否 |
用于相似度计算的节点属性及其选择的相似度度量。接受单个属性键、属性键到度量的映射,或属性键和/或映射的列表(如上所述)。详情请参见 节点属性和度量配置。 |
topK |
整数 |
|
是 |
为每个节点查找的邻居数量。将返回 K-最近邻居。此值不能低于 1。 |
sampleRate |
浮点数 |
|
是 |
限制每个节点比较次数的采样率。值必须介于 0(不含)和 1(含)之间。 |
deltaThreshold |
浮点数 |
|
是 |
以百分比表示的值,用于确定何时提前停止。如果发生的更新少于配置的值,算法将停止。值必须介于 0(不含)和 1(含)之间。 |
maxIterations |
整数 |
|
是 |
硬限制,在进行这些迭代后停止算法。 |
randomJoins |
整数 |
|
是 |
对于每次迭代,每个节点根据随机选择连接新节点邻居的随机尝试次数。 |
字符串 |
|
是 |
用于为每个节点采样前 |
|
randomSeed |
整数 |
|
是 |
控制算法随机性的种子值。请注意,设置此参数时必须将 |
similarityCutoff |
浮点数 |
|
是 |
从 K-最近邻列表中过滤掉相似度低于此阈值的节点。 |
perturbationRate |
浮点数 |
|
是 |
用相等相似度的已遇到邻居替换已知最不相似邻居的概率。 |
sourceNodeFilter |
字符串或整数列表 |
|
是 |
用于过滤源节点的节点标签字符串,或节点 ID 列表(需要 sourceNodeTable)。只有符合此过滤条件的节点才会用作相似度计算中的源节点。 |
sourceNodeTable |
字符串 |
|
是 |
使用节点 ID 过滤时源节点的完全限定表名。当 sourceNodeFilter 包含节点 ID 时为必填项。 |
targetNodeFilter |
字符串或整数列表 |
|
是 |
用于过滤目标节点的节点标签字符串,或节点 ID 列表(需要 targetNodeTable)。只有符合此过滤条件的节点才会被视为潜在邻居。 |
targetNodeTable |
字符串 |
|
是 |
使用节点 ID 过滤时目标节点的完全限定表名。当 targetNodeFilter 包含节点 ID 时为必填项。 |
seedTargetNodes |
布尔值 |
|
是 |
是否对目标节点进行种子填充以保证每个源节点得到 k 个结果。启用后,如果发现的相似度高于截止值的邻居少于 k 个,则会添加额外邻居以达到 k 个,其中可能包含低于截止值的节点。 |
| 有关以下写入配置的更多详细信息,请参阅 写入文档。 |
| 名称 | 类型 | 默认 | 可选 | 描述 |
|---|---|---|---|---|
sourceLabel |
字符串 |
|
否 |
内存图中待回写关系起始节点的节点标签。 |
targetLabel |
字符串 |
|
否 |
内存图中待回写关系结束节点的节点标签。 |
outputTable |
字符串 |
|
否 |
关系写入的 Snowflake 数据库表。 |
关系类型 (relationshipType) |
字符串 |
|
是 |
将回写到 Snowflake 数据库的关系类型。 |
relationshipProperty |
字符串 |
|
是 |
将回写到 Snowflake 数据库的关系属性。 |
|
“过滤 KNN”算法不读取任何关系,但 |
|
要在运行算法时获得确定性结果:
|
示例
在本节中,我们将展示在具体图上运行“过滤 KNN”算法的示例。使用均匀采样器 (Uniform sampler),“过滤 KNN”从过滤集中均匀随机采样初始邻居,而不考虑图的拓扑结构。这意味着“过滤 KNN”可以在仅包含节点而没有任何关系的图上运行。
考虑以下包含五个节点的图,节点具有不同标签 - 有些是 Person(人)节点,有些是 Robot(机器人)节点。
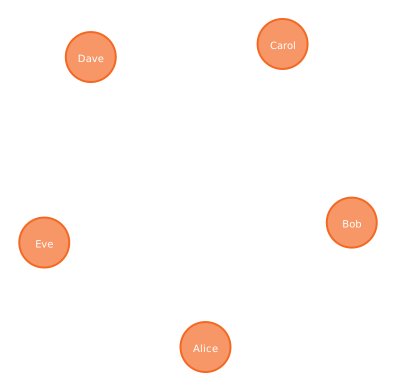
CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.NODES_PERSON (NODEID VARCHAR, AGE NUMBER, EMBEDDING ARRAY);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.NODES_PERSON SELECT 'alice', 24, ARRAY_CONSTRUCT(1.0::FLOAT, -1.0);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.NODES_PERSON SELECT 'carol', 24, ARRAY_CONSTRUCT(3.0, 5.0);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.NODES_PERSON SELECT 'eve',   67, ARRAY_CONSTRUCT(5.0, 3.0);

CREATE OR REPLACE TABLE EXAMPLE_DB.DATA_SCHEMA.NODES_ROBOT (NODEID VARCHAR, AGE NUMBER, EMBEDDING ARRAY);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.NODES_ROBOT SELECT 'bob',  73, ARRAY_CONSTRUCT(2.0::FLOAT, 2.0);
INSERT INTO EXAMPLE_DB.DATA_SCHEMA.NODES_ROBOT SELECT 'dave', 48, ARRAY_CONSTRUCT(4.0, 5.0);|
在构建上述嵌入数组时,我们需要确保数组第一行中的第一个值在 Snowflake 中是浮点类型。如果我们不附加 |
在此示例中,我们希望使用“过滤 K-近邻”算法,根据年龄和嵌入属性比较节点,并对源节点和/或目标节点应用过滤。
利用 Snowflake 中的节点表,我们现在可以将它们作为算法作业的一部分进行投影。在以下示例中,我们将演示如何在此时的图上使用“过滤 KNN”算法。
使用节点标签进行过滤
运行带有基于标签过滤的“过滤 KNN”作业涉及三个步骤:投影 (Project)、计算 (Compute) 和写入 (Write)。
要运行查询,需要为应用程序、您的消费者角色和您的环境设置必要的权限。请参阅 入门 页面以了解更多信息。
我们还假设应用程序名称为默认的 Neo4j_Graph_Analytics。如果您在安装过程中选择了不同的应用程序名称,请将其替换为该名称。
CALL Neo4j_Graph_Analytics.graph.knn_filtered('CPU_X64_XS', {
    'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
    'project': {
        'nodeTables': ['NODES_PERSON', 'NODES_ROBOT'],
        'relationshipTables': {}
    },
    'compute': {
        'nodeProperties': ['AGE', 'EMBEDDING'],
        'topK': 1,
        'sourceNodeFilter': 'nodes_person'
    },
    'write': [{
        'outputTable': 'SIMILARITY_OUTPUT',
        'sourceLabel': 'nodes_person',
        'targetLabel': 'nodes_person'
    }]
});| JOB_ID | JOB_STATUS | JOB_START | JOB_END | JOB_RESULT |
|---|---|---|---|---|
job_abc123def456ghi789 |
SUCCESS |
2025-10-22 14:30:15.123000 |
2025-10-22 14:30:20.456000 |
{
  "knn_filtered_1": {
    "computeMillis": 38,
    "configuration": {
      "concurrency": 6,
      "deltaThreshold": 0.001,
      "initialSampler": "UNIFORM",
      "maxIterations": 100,
      "nodeLabels": [
        "*"
      ],
      "nodeProperties": {
        "AGE": "LONG_PROPERTY_METRIC",
        "EMBEDDING": "COSINE"
      },
      "perturbationRate": 0,
      "randomJoins": 10,
      "relationshipTypes": [
        "*"
      ],
      "resultProperty": "similarity",
      "resultRelationshipType": "SIMILARITY",
      "sampleRate": 0.5,
      "seedTargetNodes": false,
      "similarityCutoff": 0,
      "sourceNodeFilter": "NodeFilter[label=PERSONS]",
      "targetNodeFilter": "NodeFilter[NoOp]",
      "topK": 1
    },
    "didConverge": true,
    "nodePairsConsidered": 173,
    "nodesCompared": 7,
    "ranIterations": 2,
    "similarityDistribution": {
      "max": 0.9979286193847655,
      "mean": 0.9040115356445313,
      "min": 0.5665702819824219,
      "p1": 0.5665702819824219,
      "p10": 0.5665702819824219,
      "p100": 0.9979248046875,
      "p25": 0.9598922729492188,
      "p5": 0.5665702819824219,
      "p50": 0.9977455139160156,
      "p75": 0.9979248046875,
      "p90": 0.9979248046875,
      "p95": 0.9979248046875,
      "p99": 0.9979248046875,
      "stdDev": 0.16936039641075756
    }
  },
  "project_1": {
    "graphName": "snowgraph",
    "nodeCount": 7,
    "nodeMillis": 491,
    "relationshipCount": 0,
    "relationshipMillis": 0,
    "totalMillis": 491
  },
  "write_relationship_type_1": {
    "exportMillis": 1847,
    "outputTable": "EXAMPLE_DB.DATA_SCHEMA.OUTPUT",
    "relationshipProperty": "similarity",
    "relationshipType": "SIMILARITY",
    "relationshipsExported": 2
  }
} |
返回的结果包含有关作业执行的信息。请注意,由于我们过滤为仅使用 Person 节点作为源节点,因此只导出了 3 个关系。相似度得分已回写到 Snowflake 数据库。
我们可以查询这些结果:
SELECT * FROM EXAMPLE_DB.DATA_SCHEMA.SIMILARITY_OUTPUT ORDER BY SCORE DESC;| SOURCENODEID | TARGETNODEID | SCORE |
|---|---|---|
alice |
carol |
0.8234 |
carol |
alice |
0.8234 |
eve |
carol |
0.6745 |
在此示例中,我们使用了 sourceNodeFilter: 'nodes_person' 来将源节点过滤为仅 NODES_PERSON 表中的节点。结果中只有 Person 节点(alice, carol, eve)作为源节点出现,而 Robot 节点(bob, dave)被排除在源节点之外。
使用节点 ID 和表进行过滤
“过滤 KNN”算法还支持通过特定节点 ID 进行过滤。使用节点 ID 过滤时,必须指定包含这些节点的表。
CALL Neo4j_Graph_Analytics.graph.knn_filtered('CPU_X64_XS', {
    'project': {
        'defaultTablePrefix': 'EXAMPLE_DB.DATA_SCHEMA',
        'nodeTables': ['NODES_PERSON','NODES_ROBOT'],
        'relationshipTables': {}
    },
    'compute': {
        'topK': 1,
        'nodeProperties': ['AGE', 'EMBEDDING'],
        'sourceNodeFilter': [42,44,46],
        'sourceNodeTable': 'EXAMPLE_DB.DATA_SCHEMA.NODES_PERSON',
        'targetNodeFilter': [43,45],
        'targetNodeTable': 'EXAMPLE_DB.DATA_SCHEMA.NODES_ROBOT'
    },
    'write': [{
        'outputTable': 'SIMILARITY_OUTPUT_IDS',
        'sourceLabel': 'NODES_PERSON',
        'targetLabel': 'NODES_PERSON'
    }]
});| JOB_ID | JOB_STATUS | JOB_START | JOB_END | JOB_RESULT |
|---|---|---|---|---|
job_xyz789abc012def345 |
SUCCESS |
2025-10-22 14:35:22.789000 |
2025-10-22 14:35:27.123000 |
{
  "knn_filtered_1": {
    "computeMillis": 40,
    "configuration": {
      "concurrency": 6,
      "deltaThreshold": 0.001,
      "initialSampler": "UNIFORM",
      "maxIterations": 100,
      "nodeLabels": [
        "*"
      ],
      "nodeProperties": {
        "AGE": "LONG_PROPERTY_METRIC",
        "EMBEDDING": "JACCARD"
      },
      "perturbationRate": 0,
      "randomJoins": 10,
      "relationshipTypes": [
        "*"
      ],
      "resultProperty": "similarity",
      "resultRelationshipType": "SIMILARITY",
      "sampleRate": 0.5,
      "seedTargetNodes": false,
      "similarityCutoff": 0,
      "sourceNodeFilter": [
        42,
        44,
        46
      ],
      "sourceNodeTable": "EXAMPLE_DB.DATA_SCHEMA.NODES_PERSON",
      "targetNodeFilter": [
        43,
        45
      ],
      "targetNodeTable": "EXAMPLE_DB.DATA_SCHEMA.NODES_ROBOT",
      "topK": 1
    },
    "didConverge": true,
    "nodePairsConsidered": 136,
    "nodesCompared": 5,
    "ranIterations": 2,
    "similarityDistribution": {
      "max": 0.19166755676269528,
      "mean": 0.13277800877888998,
      "min": 0.019999980926513672,
      "p1": 0.019999980926513672,
      "p10": 0.019999980926513672,
      "p100": 0.19166743755340576,
      "p25": 0.019999980926513672,
      "p5": 0.019999980926513672,
      "p50": 0.1866673231124878,
      "p75": 0.19166743755340576,
      "p90": 0.19166743755340576,
      "p95": 0.19166743755340576,
      "p99": 0.19166743755340576,
      "stdDev": 0.07977222975785117
    }
  },
  "project_1": {
    "graphName": "snowgraph",
    "nodeCount": 5,
    "nodeMillis": 415,
    "relationshipCount": 0,
    "relationshipMillis": 0,
    "totalMillis": 415
  },
  "write_relationship_type_1": {
    "exportMillis": 1779,
    "outputTable": "EXAMPLE_DB.DATA_SCHEMA.OUTPUT",
    "relationshipProperty": "similarity",
    "relationshipType": "SIMILARITY",
    "relationshipsExported": 0
  }
} |
在此示例中,我们为源过滤器和目标过滤器都指定了具体的节点 ID。sourceNodeFilter 包含来自 NODES_PERSON 表的 ID [42, 44, 46],而 targetNodeFilter 包含来自 NODES_ROBOT 表的 ID [43, 45]。请注意,导出的关系数为 0 - 这通常发生在特定节点 ID 不存在于表中,或者过滤后的源节点与目标节点之间没有有效的相似对时。