优化查询结果
本指南介绍了如何通过筛选、排序、比较、别名等方式来细化 Cypher® 查询的结果。
示例数据集
创建 免费 Aura 实例 后,点击“Connect”(连接)按钮并选择“Query”(查询)。在 Cypher 编辑器中,复制并粘贴以下 Cypher 语句并执行查询。
CREATE (matrix:Movie {title: 'The Matrix', released: 1997})
CREATE (cloudAtlas:Movie {title: 'Cloud Atlas', released: 2012})
CREATE (forrestGump:Movie {title: 'Forrest Gump', released: 1994})
CREATE (larryCrowne:Movie {title: 'Larry Crowne', released: 2011})
CREATE (keanu:Person {name: 'Keanu Reeves', born: 1964})
CREATE (robert:Person {name: 'Robert Zemeckis', born: 1951})
CREATE (tom:Person {name: 'Tom Hanks', born: 1956})
CREATE (tom)-[:ACTED_IN {roles: ['Forrest']}]->(forrestGump)
CREATE (tom)-[:ACTED_IN {roles: ['Zachry']}]->(cloudAtlas)
CREATE (tom)-[:ACTED_IN {roles: ['Larry Crowne']}]->(larryCrowne)
CREATE (tom)-[:DIRECTED]->(larryCrowne)
CREATE (robert)-[:DIRECTED]->(forrestGump)

CREATE (diana:Person {name: "Diana"})
CREATE (melissa:Person {name: "Melissa", twitter: "@melissa"})
CREATE (dan:Person {name: "Dan", twitter: "@dan", yearsExperience: 6})
CREATE (sally:Person {name: "Sally", yearsExperience: 4})
CREATE (john:Person {name: "John", yearsExperience: 5})
CREATE (jennifer:Person {name: "Jennifer", twitter: "@jennifer", yearsExperience: 5})
CREATE (joe:Person {name: "Joe"})
CREATE (mark:Person {name: "Mark", twitter: "@mark"})
CREATE (ann:Person {name: "Ann"})
CREATE (xyz:Company {name: "XYZ"})
CREATE (x:Company {name: "Company X"})
CREATE (a:Company {name: "Company A"})
CREATE (Neo4j:Company {name: "Neo4j"})
CREATE (abc:Company {name: "ABC"})
CREATE (query:Technology {type: "Query Languages"})
CREATE (etl:Technology {type: "Data ETL"})
CREATE (integrations:Technology {type: "Integrations"})
CREATE (graphs:Technology {type: "Graphs"})
CREATE (dev:Technology {type: "Application Development"})
CREATE (java:Technology {type: "Java"})
CREATE (diana)-[:LIKES]->(query)
CREATE (melissa)-[:LIKES]->(query)
CREATE (dan)-[:LIKES]->(etl)<-[:LIKES]-(melissa)
CREATE (xyz)<-[:WORKS_FOR]-(sally)-[:LIKES]->(integrations)<-[:LIKES]-(dan)
CREATE (sally)<-[:IS_FRIENDS_WITH]-(john)-[:LIKES]->(java)
CREATE (john)<-[:IS_FRIENDS_WITH]-(jennifer)-[:LIKES]->(java)
CREATE (john)-[:WORKS_FOR]->(xyz)
CREATE (sally)<-[:IS_FRIENDS_WITH]-(jennifer)-[:IS_FRIENDS_WITH]->(melissa)
CREATE (joe)-[:LIKES]->(query)
CREATE (x)<-[:WORKS_FOR]-(diana)<-[:IS_FRIENDS_WITH]-(joe)-[:IS_FRIENDS_WITH]->(mark)-[:LIKES]->(graphs)<-[:LIKES]-(jennifer)-[:WORKS_FOR {startYear: 2017}]->(Neo4j)
CREATE (ann)<-[:IS_FRIENDS_WITH]-(jennifer)-[:IS_FRIENDS_WITH]->(mark)
CREATE (john)-[:LIKES]->(dev)<-[:LIKES]-(ann)-[:IS_FRIENDS_WITH]->(dan)-[:WORKS_FOR]->(abc)
CREATE (ann)-[:WORKS_FOR]->(abc)
CREATE (a)<-[:WORKS_FOR]-(melissa)-[:LIKES]->(graphs)<-[:LIKES]-(diana)
筛选 (Filter)
属性
您可以根据属性来筛选结果。例如,要查找示例数据集中哪些人拥有 Twitter 账号,可以使用以下查询:
MATCH (p:Person)
RETURN p.name, p.twitter
由于您 MATCH 了所有 Person 节点,无论它们是否有 twitter 属性,它们都会被返回。在图中的 12 个 Person 节点中,只有 4 个(Melissa、Dan、Jennifer、Mark)包含 twitter 属性的值。因为查询匹配并返回了所有 Person 节点,所以您会得到另外 8 个 null 结果。
在 Neo4j 中,属性仅在有值时才存在(存储)。null 属性值不会被存储。这确保了您的节点和关系只保留有价值、必要的信息。
要仅返回包含值的那些结果,您可以使用 WHERE 子句并指定仅返回非 null 的结果:
MATCH (p:Person)
WHERE p.twitter IS NOT NULL
RETURN p.name, p.twitter
或者,在 Cypher 25 中使用 FILTER:
CYPHER 25
MATCH (p:Person)
FILTER p.twitter IS NOT NULL
RETURN p.name, p.twitter|
如果您使用的是其他版本的 Cypher,则需要在查询的第一行添加 要查看 |
结果为:
| p.name | p.twitter |
|---|---|
|
|
|
|
|
|
|
|
行:4 |
|
字符串和部分值
您可以使用特定的 谓词 (predicates) 配合 WHERE,根据存储在节点或关系中的部分值来筛选结果。
STARTS WITH
STARTS WITH 运算符搜索以您指定的字符串开头的属性值,例如,以字母“M”开头的名称。
MATCH (p:Person)
WHERE p.name STARTS WITH 'M'
RETURN p.name;
结果为:
| p.name |
|---|
|
|
行:2 |
CONTAINS
CONTAINS 运算符检查指定的字符串是否为属性值的一部分,例如,是否包含字母“a”。
MATCH (p:Person)
WHERE p.name CONTAINS 'a'
RETURN p.name;
结果为:
| p.name |
|---|
|
|
|
|
|
|
|
行:7 |
ENDS_WITH
ENDS_WITH 运算符搜索属性值末尾的指定字符串,例如,以“n”结尾的 name。
MATCH (p:Person)
WHERE p.name ENDS WITH 'n'
RETURN p.name;
结果为:
| p.name |
|---|
|
|
|
行:3 |
或者,您也可以在不使用字符串运算符的情况下,使用正则表达式来查找属性值。例如,如果您想查找所有包含“Jo”的名称,同时保持大小写敏感(查询默认是区分大小写的):
MATCH (p:Person)
WHERE p.name =~ 'Jo.*'
RETURN p.name| p.name |
|---|
|
|
行:2 |
如果您不希望查询区分大小写,可以使用 toLower() 配合 CONTAINS:
MATCH (p:Person)
WHERE toLower(p.name) CONTAINS "jo"
RETURN p.name
或者,使用 toUpper():
MATCH (p:Person)
WHERE toUpper(p.name) CONTAINS "JO"
RETURN p.name
这两个选项都会返回所有包含“jo”的 name 属性值,而忽略大小写。
模式 (Patterns)
例如,要查找与在 Neo4j 工作的人是朋友关系的人,您可以筛选是否存在从友谊中的 p:Person 指向 (:Company {name:'Neo4j'}) 的 [:WORKS_FOR] 关系。
MATCH (p:Person)-[r:IS_FRIENDS_WITH]->(friend:Person)
WHERE exists((p)-[:WORKS_FOR]->(:Company {name: 'Neo4j'}))
RETURN p, r, friend;
得到的结果如下:
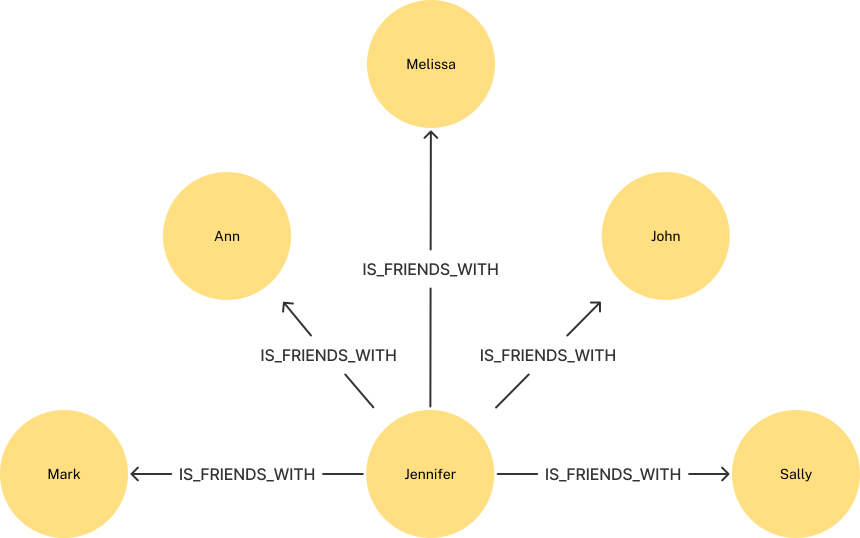
另外,您还可以通过从结果中排除某些模式来筛选结果:例如,如果您想查找 Jennifer 的朋友中哪些人没有在任何公司工作,请使用以下查询:
MATCH (p:Person)-[r:IS_FRIENDS_WITH]->(friend:Person)
WHERE p.name = 'Jennifer'
AND NOT exists((friend)-[:WORKS_FOR]->(:Company))
RETURN friend.name;
您只会得到“Mark”作为结果。
OPTIONAL 模式
有时,即使结果不符合所有条件,您也希望从查询中返回结果。为此,可以使用 OPTIONAL MATCH,它会在可选子句不匹配时返回空值 (null)。
例如,如果您搜索名字以“J”开头且“可选地”在某家公司工作的人:
MATCH (p:Person)
WHERE p.name STARTS WITH 'J'
OPTIONAL MATCH (p)-[:WORKS_FOR]-(other:Company)
RETURN p.name, other.name;
得到的结果如下:
| p.name | other.name |
|---|---|
|
|
|
|
|
|
行:3 |
|
请注意,Joe 被返回了,因为他的名字以字母“J”开头,但他的公司名称为 null。这是因为他没有指向 COMPANY 节点的 WORKS_FOR 关系。由于您使用了 OPTIONAL MATCH,他的 Person 节点仍会从第一个匹配项中返回,但未找到可选匹配项,因此 other.name 返回 null 结果。
要查看差异,尝试在第二个匹配项前去掉 OPTIONAL 运行查询。Joe 的行将不再出现在结果中。这是因为 Cypher 会将该语句读取为 AND 匹配,因此该人必须同时满足第一个条件(名字以“J”开头)和第二个条件(该人在某家公司工作)。
更复杂的模式
您可以查询具有多个关系的模式。例如,如果您想知道谁在同一家公司工作且也是朋友:
MATCH (p1:Person)-[:WORKS_FOR]->(company:Company)<-[:WORKS_FOR]-(p2:Person),
(p1)-[:IS_FRIENDS_WITH]->(p2)
RETURN p1.name AS people1, p2.name AS people2, company.name AS company
结果为:
| people1 | people2 | company |
|---|---|---|
|
|
|
|
|
|
行:2 |
||
请注意,查询的第一行末尾有一个逗号,下一行添加了另一个 MATCH 模式。这允许您将不同的模式链接在一起,类似于之前使用的 WHERE exists(<pattern>)。
利用这种结构,您可以添加多种不同的模式并将它们链接起来,从而通过特定模式遍历图的各个部分。
有关如何查询模式的更多信息,请参阅 Cypher → Patterns。
比较值
相等性
您可以使用比较来筛选值,首先是相等性:
MATCH (m:Movie)
WHERE m.title = 'The Matrix'
RETURN m
结果为:
| m |
|---|
|
行:1 |
数值
另一个选项是数值比较,以确认列表中值的存在。
以下示例中的 WHERE 子句包含大于比较,用于查找 2000 年之后发行的电影:
MATCH (m:Movie)
WHERE m.released > 2000
RETURN m.title, m.released
结果为:
| m | m.release |
|---|---|
|
|
|
|
行:2 |
|
Cypher 拥有其他数学运算符,允许进行其他类型的数值比较。请参阅 Cypher → Mathematical operators 获取完整的运算符列表和示例。
布尔值
Cypher 的布尔运算符允许您组合或评估逻辑条件。
例如,查找图中谁导演了电影但没有参演:
MATCH (p:Person)-[:DIRECTED]->(m)
WHERE NOT (p)-[:ACTED_IN]->()
RETURN p, m
结果为:
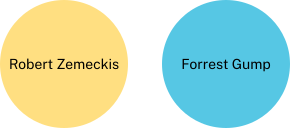
这是因为查询查找的是仅通过 DIRECTED 关系连接到 Movie 节点,而没有 ACTED_IN 关系的 Person 节点。如果不再限制 ACTED_IN 关系:
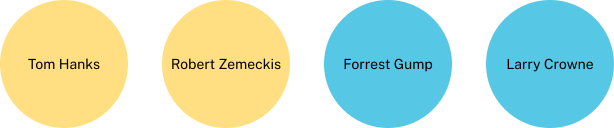
MATCH (p:Person)-[:DIRECTED]->(m)
RETURN p, m
那么结果中会包含 Tom Hanks 和电影“Larry Crowne”,因为 Tom Hanks 既导演又参演了该电影。
请参阅 Cypher → Boolean operators 获取完整的运算符列表和示例。
值范围
您可以查询特定数字或日期范围内的数据,例如,查找特定时间线内的事件、年龄值等。
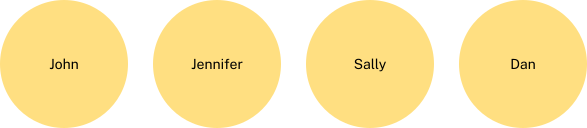
如果您想知道谁的经验在三到七年之间:
MATCH (p:Person)
WHERE 3 <= p.yearsExperience <= 7
RETURN p
结果为:
别名结果
默认情况下,Cypher 返回标签作为表格结果中的列名。但是,您可以使用 AS 使用别名使结果更易于理解。
例如,如果您想让表格结果的列标题显示为 name 而不是标签 p.name:
MATCH (p:Person)
RETURN p.name AS name
结果为:
| 名称 (name) |
|---|
|
|
|
|
|
|
|
|
|
|
|
|
Rows: 12 |
避免重复
例如,要查找哪些人通过 IS_FRIENDS_WITH 关系连接:
MATCH (p:Person)-[:IS_FRIENDS_WITH]-(friend:Person)
RETURN friend.name;
结果为:
| friend.name |
|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
Rows: 18 |
请注意,有些名字出现了不止一次。例如,“Sally”出现了两次,因为她通过两个 IS_FRIENDS_WITH 关系连接了两个人。要避免这种情况,在 RETURN 之后添加 DISTINCT:
MATCH (p:Person)-[:IS_FRIENDS_WITH]->(friend:Person)
RETURN DISTINCT friend.name;
现在结果如下:
| friend.name |
|---|
|
|
|
|
|
|
|
行:7 |
排序
如果您希望对结果进行排序,可以在 RETURN 子句之后使用 ORDER BY 子句。例如,按降序列出每个人拥有的经验年数:
MATCH (p:Person)
RETURN p.yearsExperience AS yearsExperience
ORDER BY yearsExperience DESC
结果如下:
| yearsExperience |
|---|
|
|
|
|
|
|
|
|
|
|
|
|
Rows: 12 |
请注意,前 8 行的结果包含 null。这意味着并非所有返回的 Person 节点都有 yearsExperience 属性。
由于在降序排序时 null 被视为可能的最大值,因此它们会排在数值之前。如果是升序排序,null 值将出现在最后。
(可选)您可以使用 WHERE 和 IS NOT NULL 来避免返回 null 值:
MATCH (p:Person)
WHERE p.yearsExperience IS NOT NULL
RETURN p.yearsExperience AS yearsExperience
ORDER BY yearsExperience DESC
限制 (Limit)
当您想要限制返回结果的数量时,可以使用 LIMIT。例如,当前的示例图中共有 12 个 Person 节点,如果您只想检索其中的 3 个:
MATCH (p:Person)
RETURN p
LIMIT 3
结果为:
| p |
|---|
|
|
|
行:3 |
由于您没有使用 ORDER BY 来指定排序方式,查询会检索添加到图中的前三个 Person 节点。要获取随机结果,可以在查询中添加 ORDER BY rand():
MATCH (p:Person)
RETURN p
ORDER BY rand()
LIMIT 3
现在,每次运行此查询时,您都会得到 3 个随机的 Person 节点。
聚合
Cypher 提供了几种 聚合函数 (aggregating functions),让您可以从一组值中计算出一个单一的值。
您可以将它们与 RETURN 或 WITH 子句一起使用来聚合结果。
| 函数 | 描述 |
|---|---|
返回一组 |
|
返回一个包含表达式所返回值的列表。 |
|
返回值的数量或行数。 |
|
返回一组值中的最大值。 |
|
返回一组值中的最小值。 |
|
使用线性插值法返回一组值中指定百分位数的数值。 |
|
使用舍入法返回一组值中与指定百分位数最接近的 |
|
返回给定值在样本总体中的标准差。 |
|
返回给定值在整个总体中的标准差。 |
|
返回一组 INTEGER、FLOAT 或 DURATION 值的总和。 |
请参阅 Cypher → Aggregating 获取所有聚合函数的完整列表和示例。
解构 (Unwind)
如果您有一个列表想要检查或拆分其中的值,Cypher 提供了 UNWIND 函数来实现。
例如,如果您想查看示例图中哪些人喜欢“Graphs”和/或“Query Languages”:
WITH ['Graphs','Query Languages'] AS likedTech
UNWIND likedTech AS technology
MATCH (p:Person)-[r:LIKES]-(t:Technology {type: technology})
RETURN t.type, p.name AS people;
结果为:
| t.type | people |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
行:7 |
|
您可以使用 collect() 函数将结果分组。如果您这样重写查询:
WITH ['Graphs','Query Languages'] AS likedTech
UNWIND likedTech AS technology
MATCH (p:Person)-[r:LIKES]-(t:Technology {type: technology})
RETURN t.type, collect(p.name) AS people;
结果看起来会更整洁:
| t.type | people |
|---|---|
|
|
|
|
行:2 |
|
条目数量
如果您有一个元素列表,也可以使用 size() 函数返回该列表中的元素数量。
例如,如果您想知道图中每个人有多少个朋友:
MATCH (p:Person)-[:IS_FRIENDS_WITH]-(friend:Person)
RETURN p.name, size(collect(friend.name)) AS numberOfFriends;请注意,collect() 函数是在 size() 函数内部使用的。如果您不使用它(即只写 size(friend.name)),函数的作用将是计算 friend.name 属性字符串值中包含多少个字符。因为您想知道每个人有多少个朋友,所以 collect() 作为聚合函数收集所有的 friend.name 值,而 size() 则返回总数量。
结果为:
| p.name | numberOfFriends |
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
行:9 |
|
另一点需要注意的是,如果您在关系中添加了方向:
MATCH (p:Person)-[:IS_FRIENDS_WITH]->(friend:Person)
RETURN p.name, size(collect(friend.name)) AS numberOfFriends;
您会得到不同的结果:
| p.name | numberOfFriends |
|---|---|
|
|
|
|
|
|
|
|
Rows:4 |
|
这是因为 IS_FRIENDS_WITH 关系是有向的。
例如,Jennifer 和 Mark 通过从 Jennifer 到 Mark 的出站 IS_FRIENDS_WITH 关系连接(即 (jennifer)-[:IS_FRIENDS_WITH]→(mark)),而不是 (mark)-[:IS_FRIENDS_WITH]→(jennifer)。
在实际应用中,Jennifer 和 Mark 是朋友这一点才是最重要的,因此关系的方向并不重要。但是,将此信息添加到图中时,关系 必须具有方向。另一方面,查询它并不一定需要方向。
创建方向相反的新模式(即 (mark)-[:IS_FRIENDS_WITH]→(jennifer))从语法角度看并没有错,但如果方向对于回答“谁与谁是朋友?”这个问题无关紧要,这就是重复的信息。这就是为什么使用无向关系查询可以得到更准确的结果。