教程:将关系数据库中的数据导入 Neo4j
简介
本教程演示了将数据从关系数据库(PostgreSQL)导出并导入到图数据库(Neo4j)的过程。您将学习如何通过转换模式和使用导入工具,将数据从关系系统迁移到图系统中。
或者,您可以
-
创建一个 AuraDB 云实例。
-
启动一个空白的 Neo4j 沙箱 (Sandbox)。
-
下载并安装 Neo4j Desktop。
本指南使用了一个特定的数据集,但其原理可以应用于任何数据领域并重复使用。
您应该对属性图模型有基本的了解,并知道如何将数据建模为图。
关于数据领域
在本指南中,我们将使用 Northwind 数据集,这是一个常用的 SQL 数据集。该数据描绘了一个产品销售系统,用于存储和跟踪客户、产品、客户订单、仓库库存、运输、供应商,甚至是员工及其销售区域。尽管 NorthWind 数据集常用于演示 SQL 和关系数据库,但这些数据同样可以构建为图。
Northwind 数据集的实体关系图 (ERD) 如下所示。
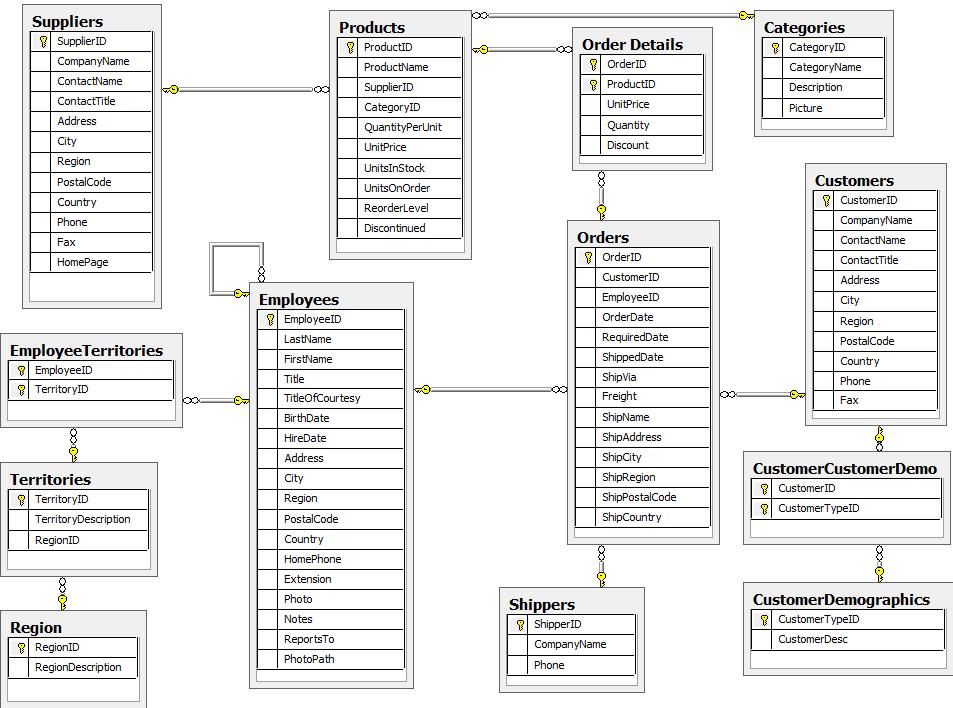
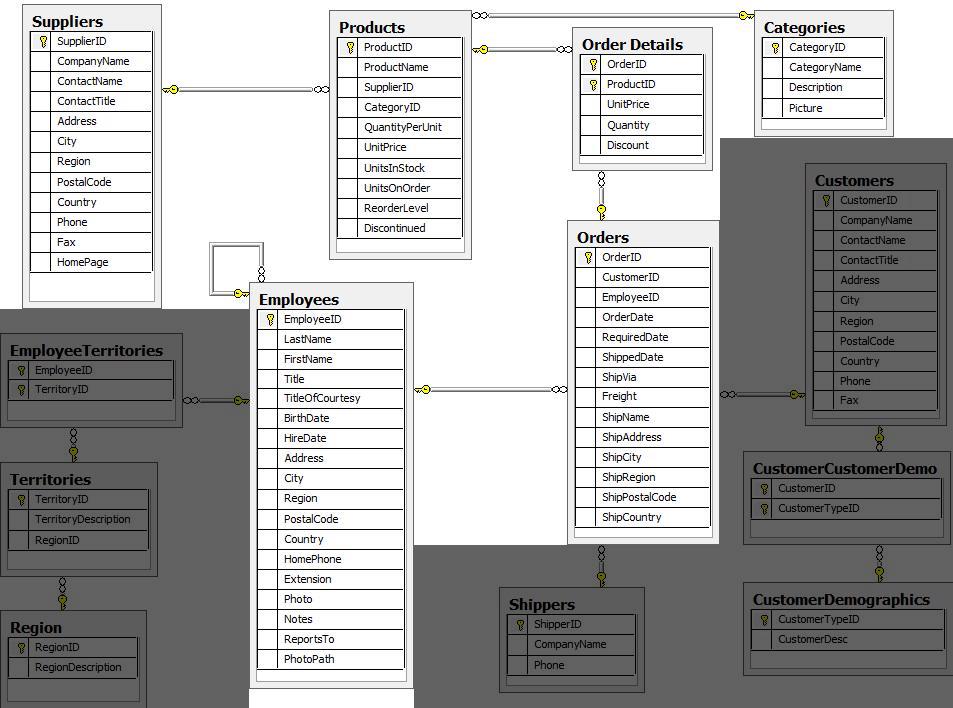
首先,这是一个相当庞大且详细的模型。我们可以为我们的示例将其简化,并选择对我们的图至关重要的实体——换句话说,那些最能从观察连接中获益的实体。对于我们的用例,我们真正想要优化的是与订单相关的关系——涉及哪些产品(以及这些产品的类别和供应商)、哪些员工负责这些订单,以及这些员工的经理。
利用这些业务需求,我们可以将模型缩减为这些核心实体。
开发图模型
要将数据从关系数据库导入到图中,您需要做的第一件事是将关系数据模型转换为图数据模型。决定如何将表和行结构化为节点和关系,取决于什么对您的业务需求最重要。
|
有关将图模型适应不同场景的更多信息,请查看我们的建模设计指南。 |
在从关系模型导出图模型时,您应记住以下几条通用准则。
-
行 即 节点。
-
表名 即 标签名。
-
连接或外键 即 关系。
牢记这些原则,我们可以按照以下步骤将我们的关系模型映射到图
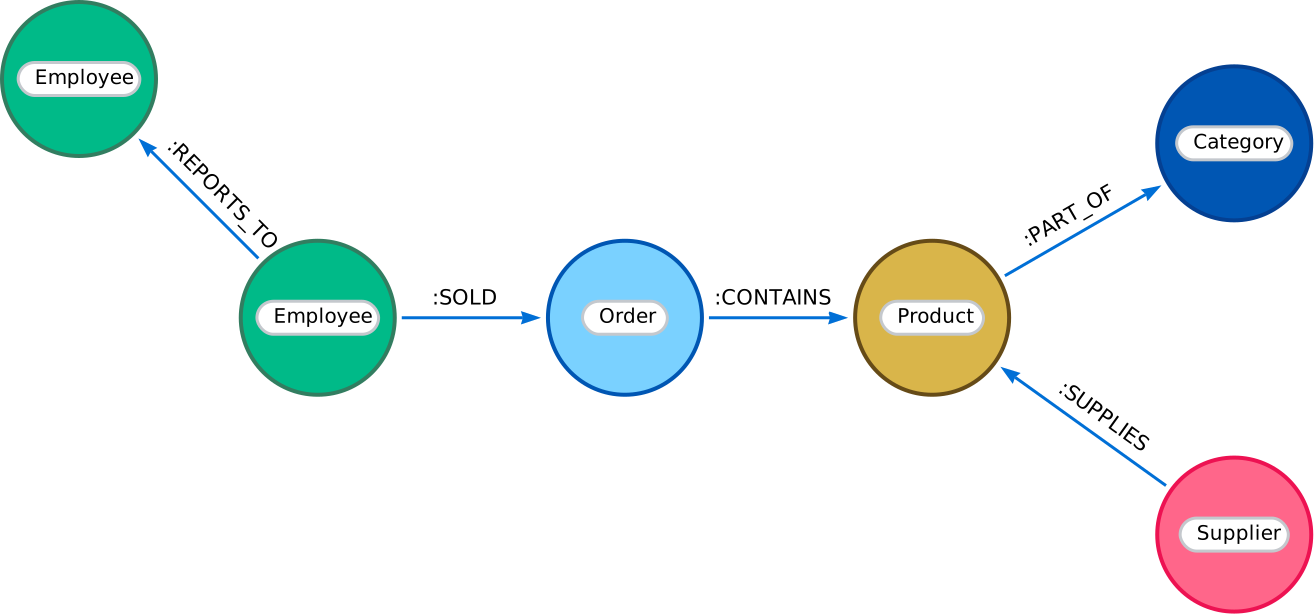
行转节点,表名转标签
-
Orders表中的每一行都成为图中的一个节点,并使用Order作为标签。 -
Products表中的每一行都成为一个节点,并使用Product作为标签。 -
Suppliers表中的每一行都成为一个节点,并使用Supplier作为标签。 -
Categories表中的每一行都成为一个节点,并使用Category作为标签。 -
Employees表中的每一行都成为一个节点,并使用Employee作为标签。
连接转关系
-
Suppliers和Products之间的连接成为名为SUPPLIES的关系(供应商供应产品)。 -
Products和Categories之间的连接成为名为PART_OF的关系(产品属于某个类别)。 -
Employees和Orders之间的连接成为名为SOLD的关系(员工销售了订单)。 -
Employees表与自身(一元关系)的连接成为名为REPORTS_TO的关系(员工拥有上级经理)。 -
Orders和Products之间通过连接表(Order Details)的连接,成为名为CONTAINS的关系,并带有unitPrice、quantity和discount等属性(订单包含产品)。
如果我们把这个转换画在白板上,我们就得到了这个图数据模型。
当然,我们也可以决定引入关系模型中的其余实体,但目前,我们将保持这个较小的图模型。
将关系表导出为 CSV
幸运的是,这一步已经为您完成,您将在本指南后面使用 Northwind 数据。
但是,如果您正在处理其他数据领域,则需要将数据从关系表中取出,并将其转换为其他格式以便加载到图中。许多系统都能处理的一种常见格式是逗号分隔值 (CSV) 的扁平文件。
以下是我们为您运行的将 Northwind 数据导出为 CSV 文件的示例脚本。
export_csv.sql
COPY (SELECT * FROM customers) TO '/tmp/customers.csv' WITH CSV header;
COPY (SELECT * FROM suppliers) TO '/tmp/suppliers.csv' WITH CSV header;
COPY (SELECT * FROM products)  TO '/tmp/products.csv' WITH CSV header;
COPY (SELECT * FROM employees) TO '/tmp/employees.csv' WITH CSV header;
COPY (SELECT * FROM categories) TO '/tmp/categories.csv' WITH CSV header;

COPY (SELECT * FROM orders
      LEFT OUTER JOIN order_details ON order_details.OrderID = orders.OrderID) TO '/tmp/orders.csv' WITH CSV header;
如果您想使用自己的 Northwind RDBMS 自行创建 CSV 文件,可以运行此脚本,命令为 psql -d northwind < export_csv.sql。
注意:除非您想针对自己的 Northwind RDBMS 执行此脚本,否则无需运行它。
使用 Cypher 导入数据
您可以使用 Cypher® 的 LOAD CSV 命令将 CSV 文件的内容转换为图结构。
当您使用 LOAD CSV 在数据库中创建节点和关系时,对于 CSV 文件的存放位置有两个选择:
-
位于您可以管理的 Neo4j 实例的 import 文件夹中。
-
从公开可用的位置(例如 S3 存储桶或 GitHub 地址)加载。如果您使用 Neo4j AuraDB 或 Neo4j Sandbox,则必须使用此选项。
如果您想为您管理的 Neo4j 实例使用 CSV 文件,可以将 CSV 文件从 GitHub 上的 Northwind 文件 复制并放置到您的 Neo4j DBMS 的 import 文件夹中。
您可以使用 Cypher 的 LOAD CSV 语句读取每个文件,并在其后添加 Cypher 子句,以获取行/列数据并将其转换为图。
接下来,您将运行 Cypher 代码以:
-
从 CSV 文件中加载节点。
-
为图中的数据创建索引和约束。
-
创建节点之间的关系。
创建 Order 节点
执行此 Cypher 块以在数据库中创建 Order 节点
// Create orders
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/orders.csv' AS row
MERGE (order:Order {orderID: row.OrderID})
  ON CREATE SET order.shipName = row.ShipName;
如果您已将 CSV 文件放入 import 文件夹中,则应使用此代码语法从本地目录加载 CSV 文件
// Create orders
LOAD CSV WITH HEADERS FROM 'file:///orders.csv' AS row
MERGE (order:Order {orderID: row.OrderID})
  ON CREATE SET order.shipName = row.ShipName;
此代码在数据库中创建了 830 个 Order 节点。
您可以通过执行以下代码来查看数据库中的某些节点
MATCH (o:Order) return o LIMIT 5;图视图是
表视图包含这些节点属性值
| o |
|---|
{"shipName":Vins et alcools Chevalier,"orderID":10248} |
{"shipName":Toms Spezialitäten,"orderID":10249} |
{"shipName":Hanari Carnes,"orderID":10250} |
{"shipName":Victuailles en stock,"orderID":10251} |
{"shipName":Suprêmes délices,"orderID":10252} |
您可能注意到并未导入 CSV 文件中的所有字段列。通过您的语句,您可以选择节点需要哪些属性,哪些可以忽略,哪些可能需要导入到其他节点类型或关系中。您可能还会注意到使用了 MERGE 关键字,而不是 CREATE。虽然我们相当确定 CSV 文件中没有重复项,但使用 MERGE 是确保数据库中实体唯一的良好实践。
创建 Product 节点
执行此代码以在数据库中创建 Product 节点
// Create products
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/products.csv' AS row
MERGE (product:Product {productID: row.ProductID})
  ON CREATE SET product.productName = row.ProductName, product.unitPrice = toFloat(row.UnitPrice);
此代码在数据库中创建了 77 个 Product 节点。
您可以通过执行此代码查看数据库中的一些节点
MATCH (p:Product) return p LIMIT 5;图视图是
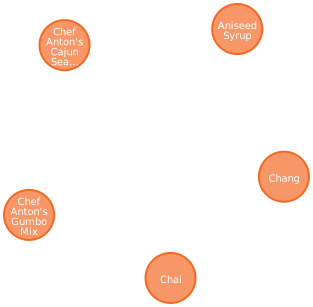
表视图包含这些节点属性值
| p |
|---|
{"unitPrice":18.0,"productID":1,"productName":Chai} |
{"unitPrice":19.0,"productID":2,"productName":Chang} |
{"unitPrice":10.0,"productID":3,"productName":Aniseed Syrup} |
{"unitPrice":22.0,"productID":4,"productName":Chef Anton’s Cajun Seasoning} |
{"unitPrice":21.35,"productID":5,"productName":Chef Anton’s Gumbo Mix} |
创建 Supplier 节点
执行此代码以在数据库中创建 Supplier 节点
// Create suppliers
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/suppliers.csv' AS row
MERGE (supplier:Supplier {supplierID: row.SupplierID})
  ON CREATE SET supplier.companyName = row.CompanyName;
此代码在数据库中创建了 29 个 Supplier 节点。
您可以通过执行此代码查看数据库中的一些节点
MATCH (s:Supplier) return s LIMIT 5;图视图是
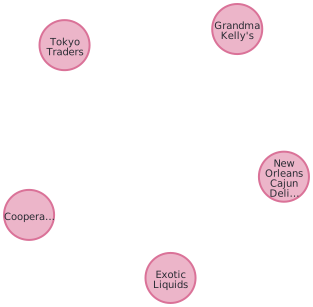
表视图包含这些节点属性值
| s |
|---|
{"supplierID":1,"companyName":Exotic Liquids} |
{"supplierID":2,"companyName":New Orleans Cajun Delights} |
{"supplierID":3,"companyName":Grandma Kelly’s Homestead} |
{"supplierID":4,"companyName":Tokyo Traders} |
{"supplierID":5,"companyName":Cooperativa de Quesos 'Las Cabras'} |
创建 Employee 节点
执行此代码以在数据库中创建 Supplier 节点
// Create employees
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/employees.csv' AS row
MERGE (e:Employee {employeeID:row.EmployeeID})
  ON CREATE SET e.firstName = row.FirstName, e.lastName = row.LastName, e.title = row.Title;
此代码在数据库中创建了 9 个 Employee 节点。
您可以通过执行此代码查看数据库中的一些节点
MATCH (e:Employee) return e LIMIT 5;图视图是
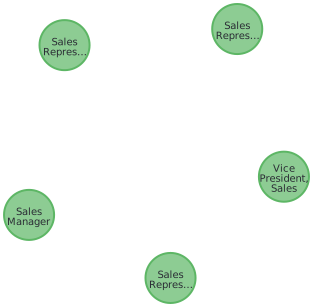
表视图包含这些节点属性值
| e |
|---|
{"lastName":Davolio,"firstName":Nancy,"employeeID":1,"title":Sales Representative} |
{"lastName":Fuller,"firstName":Andrew,"employeeID":2,"title":Vice President, Sales} |
{"lastName":Leverling,"firstName":Janet,"employeeID":3,"title":Sales Representative} |
{"lastName":Peacock,"firstName":Margaret,"employeeID":4,"title":Sales Representative} |
{"lastName":Buchanan,"firstName":Steven,"employeeID":5,"title":Sales Manager} |
创建 Category 节点
// Create categories
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/categories.csv' AS row
MERGE (c:Category {categoryID: row.CategoryID})
  ON CREATE SET c.categoryName = row.CategoryName, c.description = row.Description;
此代码在数据库中创建了 8 个 Category 节点。
您可以通过执行此代码查看数据库中的一些节点
MATCH (c:Category) return c LIMIT 5;图视图是
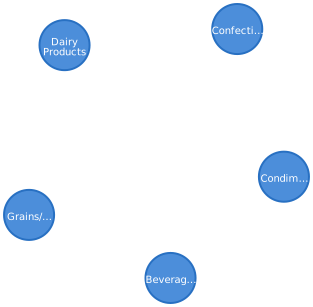
表视图包含这些节点属性值
| c |
|---|
{"description":Soft drinks, coffees, teas, beers, and ales,"categoryName":Beverages,"categoryID":1} |
{"description":Sweet and savory sauces, relishes, spreads, and seasonings,"categoryName":Condiments,"categoryID":2} |
{"description":Desserts, candies, and sweet breads,"categoryName":Confections,"categoryID":3} |
{"description":Cheeses,"categoryName":Dairy Products,"categoryID":4} |
{"description":Breads, crackers, pasta, and cereal,"categoryName":Grains/Cereals,"categoryID":5} |
|
对于非常大的商业或企业数据集,您可能会遇到内存溢出错误,特别是在小型机器上。为了避免这种情况,您可以使用 |
为图中的数据创建索引和约束
创建节点后,您需要创建它们之间的关系。导入关系意味着查找您刚刚创建的节点,并在这些现有实体之间添加关系。为了确保节点查找得到优化,您需要为查找中使用的任何节点属性(通常是 ID 或其他唯一值)创建索引。
我们还想创建一个约束(同时也创建了一个索引),以防止创建具有相同 ID 的订单,从而避免重复。最后,由于索引是在插入节点后创建的,它们的填充是异步发生的,因此我们调用 db.awaitIndexes() 进行阻塞,直到它们完成填充。
执行此代码块
CREATE INDEX product_id FOR (p:Product) ON (p.productID);
CREATE INDEX product_name FOR (p:Product) ON (p.productName);
CREATE INDEX supplier_id FOR (s:Supplier) ON (s.supplierID);
CREATE INDEX employee_id FOR (e:Employee) ON (e.employeeID);
CREATE INDEX category_id FOR (c:Category) ON (c.categoryID);
CREATE CONSTRAINT order_id FOR (o:Order) REQUIRE o.orderID IS UNIQUE;
CALL db.awaitIndexes();
执行此代码后,您可以运行以下 Cypher 命令来查看数据库中的索引
SHOW INDEXES;创建 Neo4j 数据库时,默认存在两个标记查找索引(一个用于节点标签,一个用于关系类型)。它们专门解决节点标签和关系类型谓词,并辅助填充其他索引。删除它们可能会对性能产生负面影响。您应该在数据库中看到这些索引(和约束)
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|id|name          |state |populationPercent|type  |entityType  |labelsOrTypes|properties   |indexprovider   |owningConstraint|lastRead                      |readCount|
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|7 |category_id   |ONLINE|100.0            |RANGE |NODE        |[Category]   |[categoryID] |range-1.0       |null            |null                          |0        |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|6 |employee_id   |ONLINE|100.0            |RANGE |NODE        |[Employee]   |[employeeID] |range-1.0       |null            |null                          |0        |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|1 |index_343aff4e|ONLINE|100.0            |LOOKUP|NODE        |null         |null         |token-lookup-1.0|null            |2023-12-06T12:30:12.510000000Z|2286     |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|2 |index_f7700477|ONLINE|100.0            |LOOKUP|RELATIONSHIP|null         |null         |token-lookup-1.0|null            |null                          |0        |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|8 |order_id      |ONLINE|100.0            |RANGE |NODE        |[Order]      |[orderID]    |range-1.0       |order_id        |2023-12-06T13:22:06.950000000Z|3815     |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|3 |product_id    |ONLINE|100.0            |RANGE |NODE        |[Product]    |[productID]  |range-1.0       |null            |null                          |0        |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|4 |product_name  |ONLINE|100.0            |RANGE |NODE        |[Product]    |[productName]|range-1.0       |null            |null                          |0        |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
|5 |supplier_id   |ONLINE|100.0            |RANGE |NODE        |[Supplier]   |[supplierID] |range-1.0       |null            |null                          |0        |
+---------------------------------------------------------------------------------------------------------------------------------------------------------------------+
有关索引及其在 Neo4j 中使用的更多信息,请转至 Cypher 手册 → 索引的使用。
创建节点之间的关系
接下来您必须创建关系
-
在 Orders 和 Employees 之间。
-
在 Products 和 Suppliers 之间,以及 Products 和 Categories 之间。
-
在 Employees 之间。
创建 Orders 和 Employees 之间的关系
在初始节点和索引就位后,您现在可以创建订单到产品以及订单到员工的关系。
执行此代码块
// Create relationships between orders and products
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/orders.csv' AS row
MATCH (order:Order {orderID: row.OrderID})
MATCH (product:Product {productID: row.ProductID})
MERGE (order)-[op:CONTAINS]->(product)
  ON CREATE SET op.unitPrice = toFloat(row.UnitPrice), op.quantity = toFloat(row.Quantity);
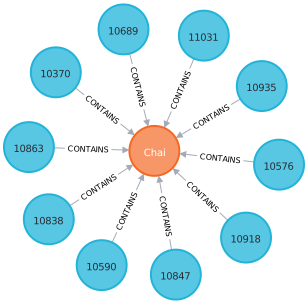
此代码在图中创建了 2155 个关系。
您可以通过执行此代码查看其中的一些关系
MATCH (o:Order)-[]-(p:Product)
RETURN o,p LIMIT 10;
您的图视图应该看起来像这样
然后,执行此代码块
// Create relationships between orders and employees
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/orders.csv' AS row
MATCH (order:Order {orderID: row.OrderID})
MATCH (employee:Employee {employeeID: row.EmployeeID})
MERGE (employee)-[:SOLD]->(order);
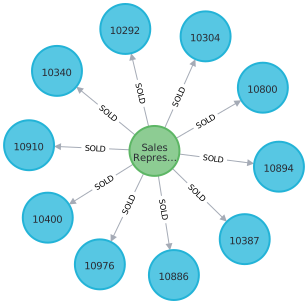
此代码在图中创建了 830 个关系。
您可以通过执行此代码查看其中的一些关系
MATCH (o:Order)-[]-(e:Employee)
RETURN o,e LIMIT 10;
您的图视图应该看起来像这样
创建 Products 和 Suppliers 之间以及 Products 和 Categories 之间的关系
接下来,在 Products、Suppliers 和 Categories 之间创建关系
执行此代码块
// Create relationships between products and suppliers
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/products.csv
' AS row
MATCH (product:Product {productID: row.ProductID})
MATCH (supplier:Supplier {supplierID: row.SupplierID})
MERGE (supplier)-[:SUPPLIES]->(product);
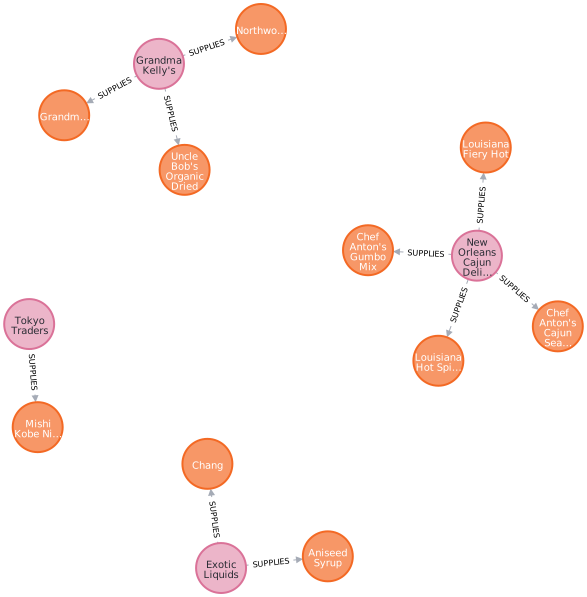
此代码在图中创建了 77 个关系。
您可以通过执行此代码查看其中的一些关系
MATCH (s:Supplier)-[]-(p:Product)
RETURN s,p LIMIT 10;
您的图视图应该看起来像这样
然后,执行此代码块
// Create relationships between products and categories
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/products.csv
' AS row
MATCH (product:Product {productID: row.ProductID})
MATCH (category:Category {categoryID: row.CategoryID})
MERGE (product)-[:PART_OF]->(category);
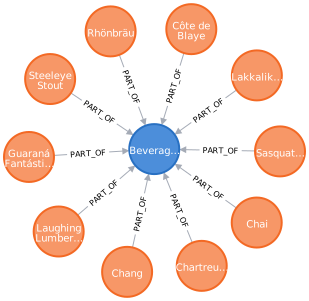
此代码在图中创建了 77 个关系。
您可以通过执行此代码查看其中的一些关系
MATCH (c:Category)-[]-(p:Product)
RETURN c,p LIMIT 10;
您的图视图应该看起来像这样
创建 Employees 之间的关系
最后,您将在 Employees 之间创建“REPORTS_TO”关系,以表示报告结构
执行此代码块
// Create relationships between employees (reporting hierarchy)
LOAD CSV WITH HEADERS FROM 'https://gist.githubusercontent.com/jexp/054bc6baf36604061bf407aa8cd08608/raw/8bdd36dfc88381995e6823ff3f419b5a0cb8ac4f/employees.csv' AS row
MATCH (employee:Employee {employeeID: row.EmployeeID})
MATCH (manager:Employee {employeeID: row.ReportsTo})
MERGE (employee)-[:REPORTS_TO]->(manager);
此代码在图中创建了 8 个关系。
您可以通过执行此代码查看其中的一些关系
MATCH (e1:Employee)-[]-(e2:Employee)
RETURN e1,e2 LIMIT 10;
您的图视图应该看起来像这样
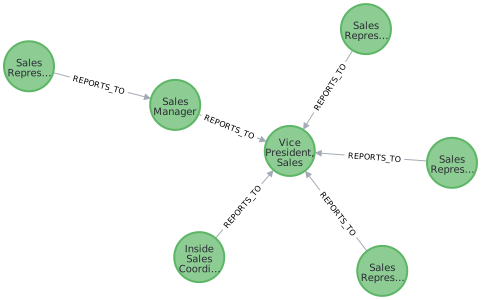
接下来,您将查询生成的图,看看它能告诉我们关于我们新导入的数据的什么信息。
查询图数据
我们可以先运行几个常规查询,以验证我们的数据是否符合我们在指南前面设计的模型。以下是一些示例查询。
执行此代码块
//find a sample of employees who sold orders with their ordered products
MATCH (e:Employee)-[rel:SOLD]->(o:Order)-[rel2:CONTAINS]->(p:Product)
RETURN e, rel, o, rel2, p LIMIT 25;
执行此代码块
//find the supplier and category for a specific product
MATCH (s:Supplier)-[r1:SUPPLIES]->(p:Product {productName: 'Chocolade'})-[r2:PART_OF]->(c:Category)
RETURN s, r1, p, r2, c;
一旦您确信数据符合我们的数据模型并且看起来一切正确,您就可以开始查询以收集信息并洞察业务决策。
哪位员工在“Chocolade”和其他产品的交叉销售次数最高?
执行此代码块
MATCH (choc:Product {productName:'Chocolade'})<-[:CONTAINS]-(:Order)<-[:SOLD]-(employee),
      (employee)-[:SOLD]->(o2)-[:CONTAINS]->(other:Product)
RETURN employee.employeeID as employee, other.productName as otherProduct, count(distinct o2) as count
ORDER BY count DESC
LIMIT 5;
看起来 4 号员工很忙,尽管 1 号员工也做得不错!您的结果应该看起来像这样
| employee | otherProduct | count |
|---|---|---|
4 |
Gnocchi di nonna Alice |
14 |
4 |
Pâté chinois |
12 |
1 |
Flotemysost |
12 |
3 |
Gumbär Gummibärchen |
12 |
1 |
Pavlova |
11 |
员工是如何组织的?谁向谁汇报?
执行此代码块
MATCH (e:Employee)<-[:REPORTS_TO]-(sub)
RETURN e.employeeID AS manager, sub.employeeID AS employee;
您的结果应该看起来像这样
| manager | employee |
|---|---|
2 |
3 |
2 |
4 |
2 |
5 |
2 |
1 |
2 |
8 |
5 |
9 |
5 |
7 |
5 |
6 |
请注意,5 号员工既有向他们汇报的人,也向 2 号员工汇报。
接下来,让我们深入调查一下。
哪些员工间接向彼此汇报?
执行此代码块
MATCH path = (e:Employee)<-[:REPORTS_TO*]-(sub)
WITH e, sub, [person in NODES(path) | person.employeeID][1..-1] AS path
RETURN e.employeeID AS manager, path as middleManager, sub.employeeID AS employee
ORDER BY size(path);
您的结果应该看起来像这样
| manager | middleManager | employee |
|---|---|---|
2 |
[] |
3 |
2 |
[] |
4 |
2 |
[] |
5 |
2 |
[] |
1 |
2 |
[] |
8 |
5 |
[] |
9 |
5 |
[] |
7 |
5 |
[] |
6 |
2 |
[5] |
9 |
2 |
[5] |
7 |
2 |
[5] |
6 |
等级制度的每一部分完成了多少订单?
执行此代码块
MATCH (e:Employee)
OPTIONAL MATCH (e)<-[:REPORTS_TO*0..]-(sub)-[:SOLD]->(order)
RETURN e.employeeID as employee, [x IN COLLECT(DISTINCT sub.employeeID) WHERE x <> e.employeeID] AS reportsTo, COUNT(distinct order) AS totalOrders
ORDER BY totalOrders DESC;
您的结果应该看起来像这样
| employee | reportsTo | totalOrders |
|---|---|---|
2 |
[8,1,5,6,7,9,4,3] |
830 |
5 |
[6,7,9] |
224 |
4 |
[] |
156 |
3 |
[] |
127 |
1 |
[] |
123 |
8 |
[] |
104 |
7 |
[] |
72 |
6 |
[] |
67 |
9 |
[] |
43 |
接下来做什么?
如果您按照本指南的每个步骤操作,那么您可能需要通过更多查询来探索数据集,并尝试回答您为数据提出的其他问题。您还可以将这些相同的原则应用于您自己或其他数据集进行分析。
如果您将此作为流程来应用于不同的数据集,或者想接下来这样做,请随时从头开始,并使用另一个领域再次研读本指南。步骤和流程仍然适用(当然,数据模型、查询和业务问题需要相应调整)。
如果您拥有的数据需要比本指南所涵盖的内容更多的清洗和操作,APOC 库可能会有所帮助。它包含数百个过程和函数,用于处理大量数据、转换值、清理混乱的数据源等等!
如果您有兴趣将关系数据一次性初始导入到 Neo4j,那么 Neo4j ETL 工具可能是您正在寻找的。该应用程序采用点击式用户界面设计,旨在实现快速、简单的关系到图的加载,帮助新老用户在无需 Cypher、导入过程或其他代码的情况下,通过将数据视为图而获得更快的价值。
资源
-
Northwind SQL, CSV 和 Cypher 数据文件,也可作为 zip 文件使用
-
LOAD CSV:用于导入 CSV 文件的 Cypher 命令
-
APOC 库:Neo4j 的实用工具库
-
Neo4j ETL 工具:无需代码即可加载关系数据